ChatGPT چگونه کار میکند؟ بررسی ساده معماری، مدل زبانی و نحوه تولید پاسخ
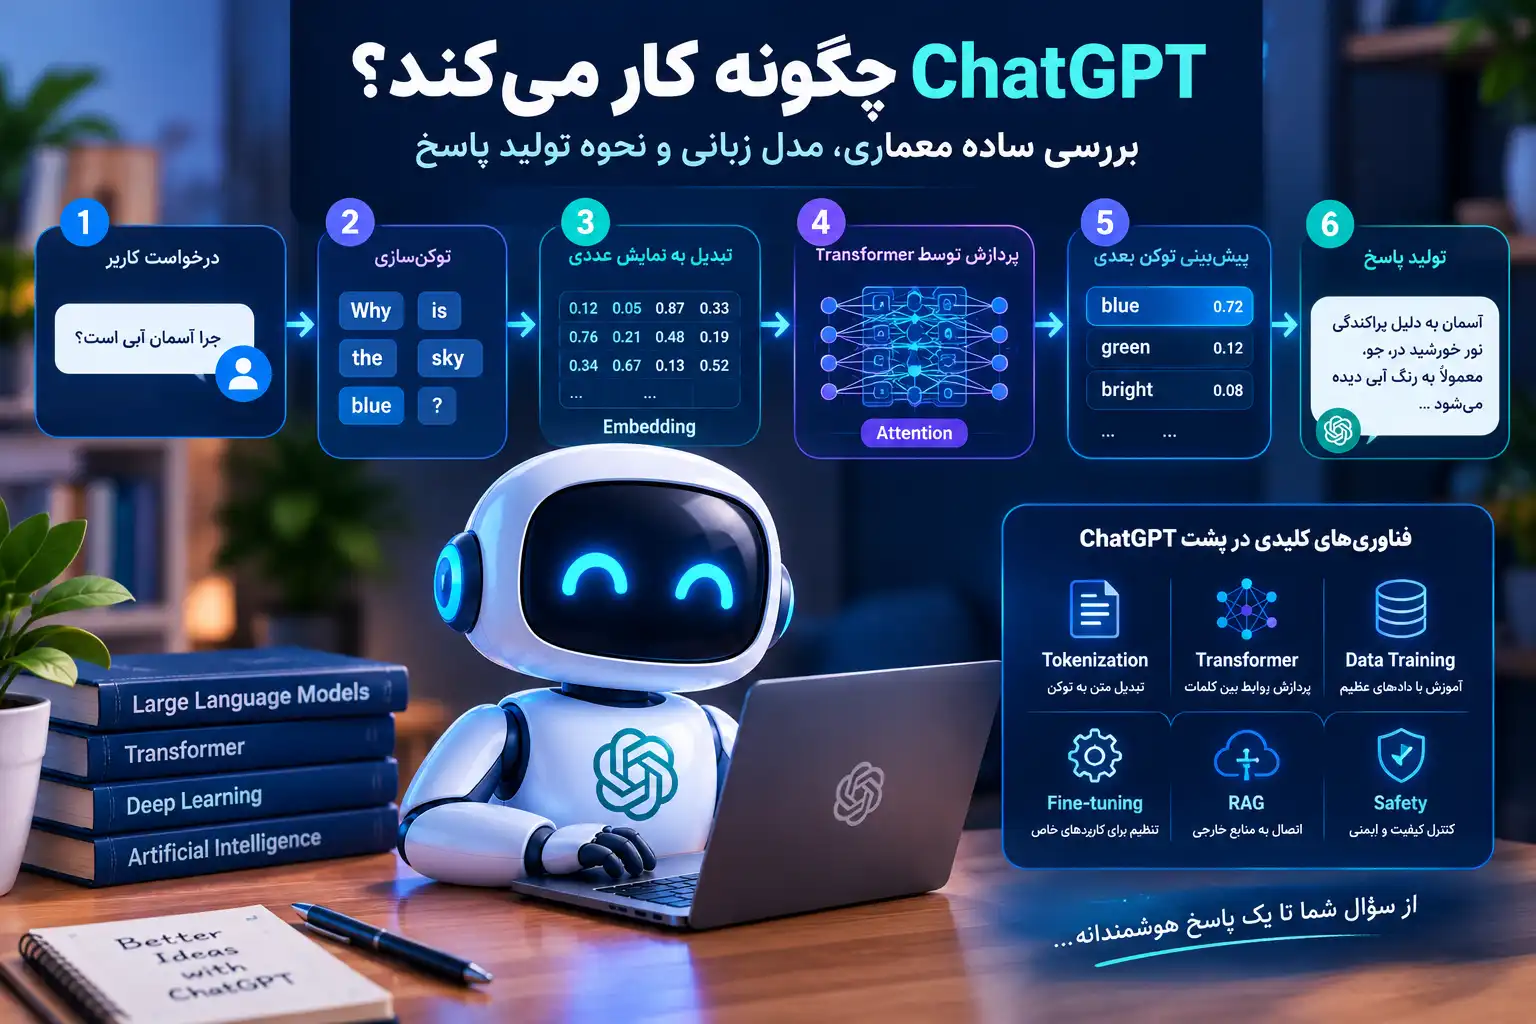
ChatGPT چگونه کار میکند؟ بررسی ساده معماری، مدل زبانی و نحوه تولید پاسخ
وقتی از ChatGPT میپرسید «برای من یک ایمیل بنویس»، «این متن را خلاصه کن» یا حتی یک سؤال پیچیده ریاضی و برنامهنویسی مطرح میکنید، پاسخ معمولاً در چند لحظه ظاهر میشود. اما پشت این پاسخ ظاهراً ساده، مجموعهای از مدلهای هوش مصنوعی، شبکههای عصبی، توکنها، معماری Transformer و میلیاردها محاسبه ریاضی قرار دارد.

مطالب مشابه: چگونه با ChatGPT کدنویسی کنیم؟ آموزش کامل از نوشتن کد تا رفع خطا

اما ChatGPT چگونه کار میکند؟ آیا پاسخها را از یک بانک اطلاعاتی پیدا میکند؟ آیا واقعاً مانند انسان فکر میکند؟ چرا گاهی پاسخ کاملاً درست و گاهی پاسخ اشتباه اما بسیار مطمئن ارائه میدهد؟
مطالب مشابه: کاربردها، امکانات و روش استفاده ChatGPT چیست؟
برای فهم این موضوع لازم نیست متخصص هوش مصنوعی باشید. در این مقاله، سازوکار ChatGPT را از لحظهای که سؤال خود را وارد میکنید تا زمانی که پاسخ روی صفحه ظاهر میشود، به زبان ساده بررسی میکنیم.
ChatGPT در یک نگاه چگونه کار میکند؟
اگر بخواهیم کل فرایند را در سادهترین شکل خلاصه کنیم، میتوان گفت:
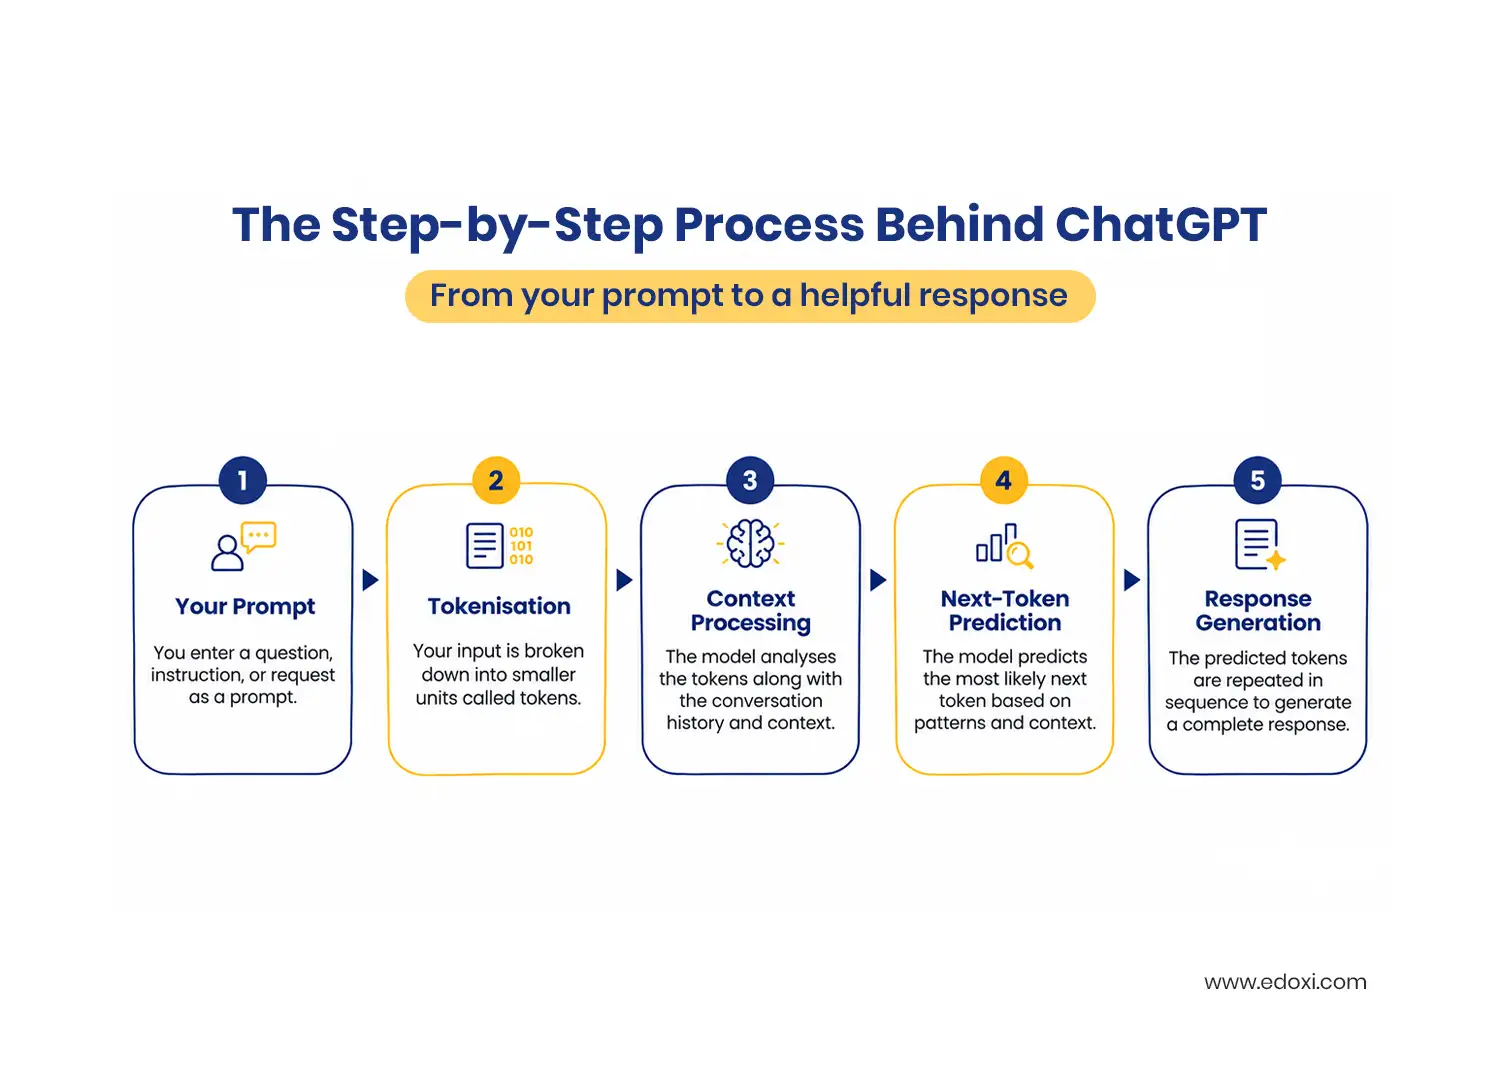
پرامپت شما → تبدیل متن به توکن → تبدیل توکنها به نمایش عددی → پردازش توسط شبکه Transformer → بررسی Context → پیشبینی توکن بعدی → تولید پاسخ
این فرایند بارها تکرار میشود تا پاسخ کامل شود.
بنابراین ChatGPT معمولاً پاسخ آمادهای را از یک فایل یا بانک اطلاعاتی بیرون نمیکشد؛ مدل بر اساس الگوهایی که در زمان آموزش یاد گرفته و اطلاعات موجود در درخواست و زمینه مکالمه، خروجی را تولید میکند.
البته ChatGPT امروزی فقط یک مدل زبانی ساده نیست. بسته به قابلیتها و نوع درخواست، میتواند از مدلهای مختلف، ابزارها و قابلیتهایی مانند جستوجوی وب، تحلیل فایل، پردازش تصویر و سایر ابزارهای متصل نیز استفاده کند.
ChatGPT چیست؟
ChatGPT یک دستیار هوش مصنوعی از OpenAI است که برای تعامل مکالمهای با کاربر طراحی شده است. کاربر میتواند سؤال، دستور، متن، تصویر یا در قابلیتهای پشتیبانیشده انواع دیگری از ورودی را ارائه کند و سیستم بر اساس مدلها و ابزارهای در دسترس، پاسخ تولید کند.
نکته مهم این است که ChatGPT و مدل زبانی دقیقاً یک چیز نیستند.
مدل زبانی را میتوان موتور هوش مصنوعی در نظر گرفت، در حالی که ChatGPT محصول و محیطی است که این مدلها را در اختیار کاربر قرار میدهد و میتواند قابلیتهای دیگری را نیز به آنها اضافه کند.
به همین دلیل، نباید تصور کنیم تمام نسخههای ChatGPT همیشه از یک مدل واحد و یک معماری کاملاً ثابت استفاده میکنند.
GPT در ChatGPT یعنی چه؟
GPT مخفف عبارت Generative Pre-trained Transformer است:
- Generative: توانایی تولید محتوا
- Pre-trained: آموزشدیده پیش از استفاده توسط کاربر
- Transformer: نوعی معماری شبکه عصبی که برای پردازش دادههای دنبالهای، از جمله زبان، بسیار مهم است
با این حال، این نکته را باید در نظر گرفت که نام ChatGPT امروزی لزوماً به این معنا نیست که تمام قابلیتهای محصول توسط یک مدل واحد با معماری یکسان انجام میشوند.
به بیان ساده، GPT نام خانوادهای از مدلها و یک مفهوم معماری مهم در تاریخ توسعه این فناوری است؛ در حالی که ChatGPT یک محصول گستردهتر است که میتواند از مدلها و ابزارهای مختلف استفاده کند.
مدل زبانی بزرگ یا LLM چیست؟
یکی از مهمترین قطعات فناوری پشت ChatGPT، مدل زبانی بزرگ یا LLM است.
مطالب مشابه: مدل زبانی بزرگ یا LLM چیست و چگونه کار میکند؟
LLM مدلی است که با حجم بسیار بزرگی از دادهها آموزش میبیند تا بتواند الگوهای موجود در زبان را تشخیص دهد. این مدل بهجای اینکه برای هر سؤال یک پاسخ از پیش نوشتهشده داشته باشد، روابط آماری میان توکنها، کلمات، جملهها و مفاهیم را یاد میگیرد.
برای مثال، اگر مدل بارها در دادههای آموزشی با جملههایی مانند:
«پایتخت فرانسه …»
مواجه شده باشد، بهتدریج یاد میگیرد که در چنین زمینهای، «پاریس» احتمال بالایی برای ادامه جمله دارد.
البته مدلهای امروزی بسیار پیچیدهتر از یک سیستم ساده تکمیل جمله هستند. آنها روابط میان بخشهای مختلف متن، زمینه مکالمه، ساختار زبان و الگوهای بسیار پیچیدهتری را مدل میکنند.
ChatGPT قبل از پاسخ دادن، متن شما را به توکن تبدیل میکند
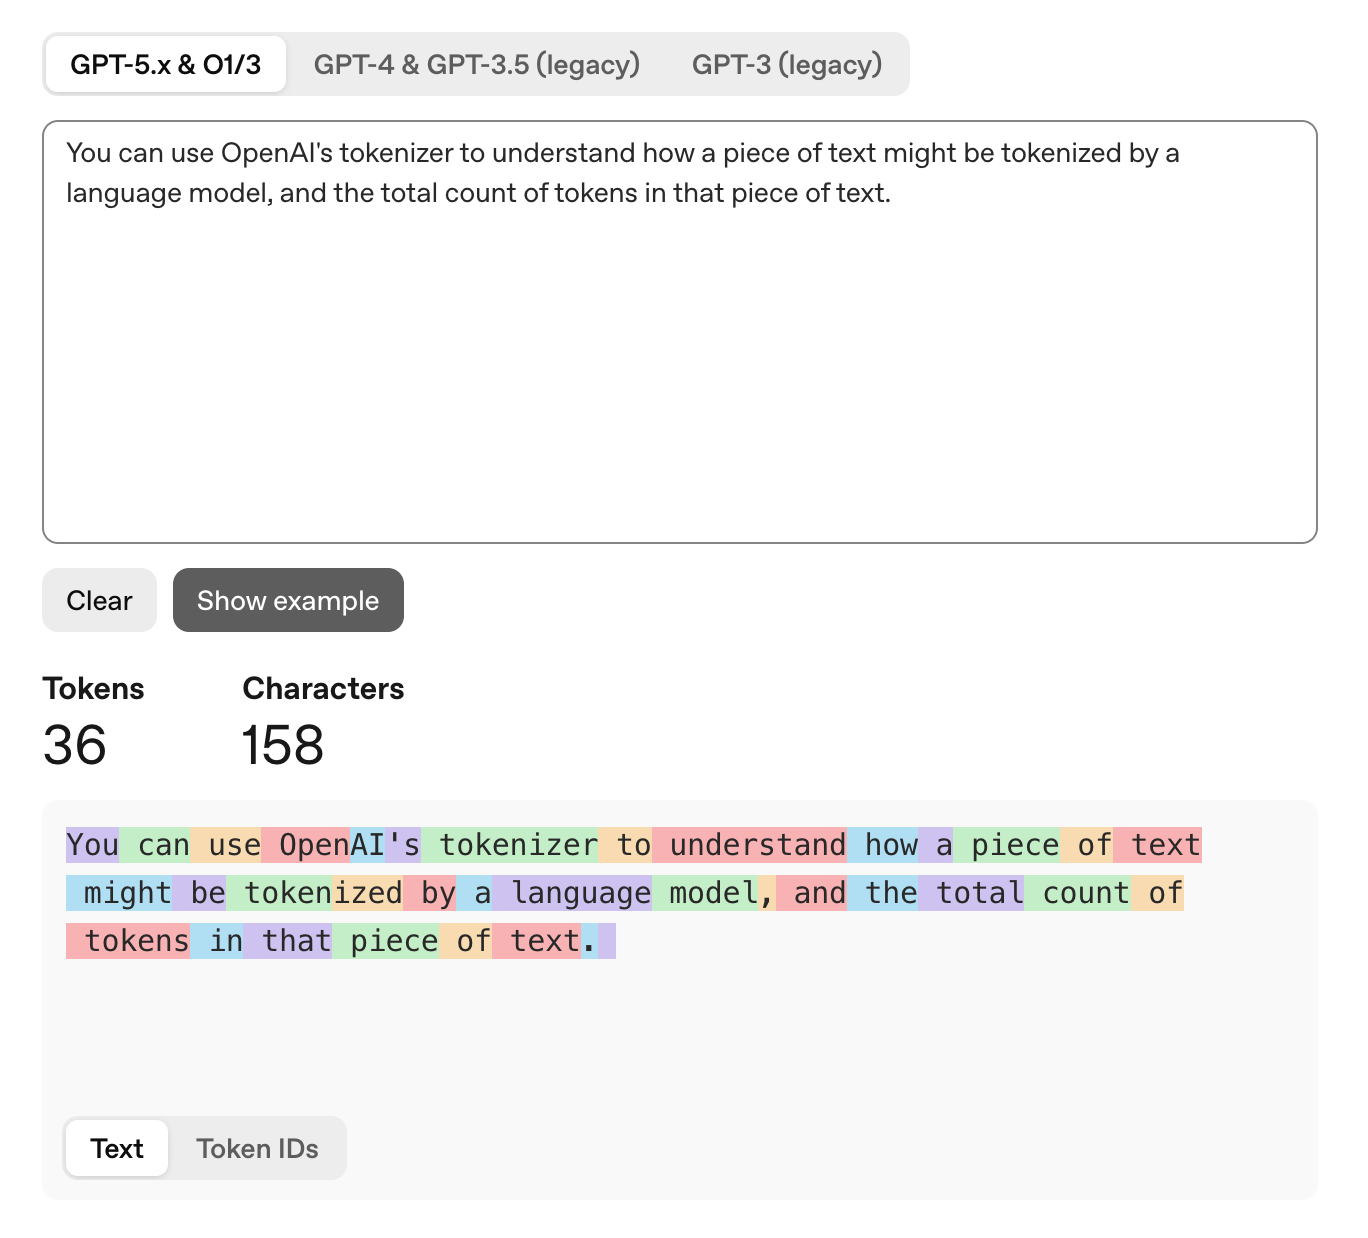
یکی از مهمترین مفاهیم برای فهم نحوه کار ChatGPT، Token یا توکن است.
مدل زبان مستقیماً مانند انسان با کلمات و جملهها کار نمیکند. متن ابتدا به واحدهای کوچکتری به نام توکن تقسیم میشود.
یک توکن میتواند:
- یک کلمه کامل باشد
- بخشی از یک کلمه باشد
- علامت نگارشی باشد
- یا بخش دیگری از متن باشد
برای مثال، یک کلمه طولانی ممکن است به چند توکن تقسیم شود.
این موضوع فقط یک جزئیات فنی نیست؛ تعداد توکنها روی مقدار متنی که مدل میتواند در یک نوبت پردازش کند نیز تأثیر دارد.
چرا توکن اهمیت دارد؟
چون مدل در نهایت با همین واحدها کار میکند.
بهصورت ساده:
متن انسانی → توکنها → نمایش عددی → پردازش مدل → توکنهای خروجی → متن قابل خواندن
به همین دلیل است که مفاهیمی مانند تعداد توکن و Context Window در سیستمهای هوش مصنوعی اهمیت دارند.
Embedding چیست؟
پس از تبدیل متن به توکن، مدل باید بتواند آنها را به شکلی عددی پردازش کند.
در این مرحله، توکنها به نمایشهای عددی موسوم به Embedding تبدیل میشوند.
Embedding را میتوان یک نمایش ریاضی از توکن در نظر گرفت که به مدل اجازه میدهد روابط و شباهتهای میان بخشهای مختلف زبان را بهتر پردازش کند.
به زبان ساده، کامپیوتر نمیتواند معنای «کتاب»، «مدرسه» یا «برنامهنویسی» را مانند ذهن انسان تصور کند. مدل این مفاهیم را در قالب نمایشهای عددی و روابط ریاضی پردازش میکند.
همین تبدیل متن به دادههای عددی یکی از پایههای اصلی عملکرد مدلهای زبانی مدرن است.
Transformer چیست و چه نقشی در ChatGPT دارد؟
Transformer یکی از مهمترین فناوریهایی است که به مدلهای زبانی مدرن اجازه میدهد ارتباط میان بخشهای مختلف یک متن را بررسی کنند.
ایده اصلی Transformer بر سازوکاری به نام Attention یا توجه استوار است.
فرض کنید جملهای داریم:
«علی کتاب را روی میز گذاشت، چون آن خیلی سنگین بود.»
برای درک درست جمله، مدل باید بداند «آن» به کدام بخش اشاره میکند.
Attention کمک میکند مدل هنگام پردازش یک بخش از متن، به بخشهای مرتبط دیگر توجه بیشتری داشته باشد.
در نتیجه مدل مجبور نیست فقط به نزدیکترین کلمه نگاه کند؛ بلکه میتواند روابط میان بخشهای مختلف ورودی را بررسی کند.
Attention چگونه به ChatGPT کمک میکند؟
فرض کنید از ChatGPT یک سؤال چندخطی میپرسید و در انتهای پیام به چیزی اشاره میکنید که ابتدای درخواست گفتهاید.
مدل باید ارتباط این دو قسمت را در نظر بگیرد.
Attention به مدل کمک میکند مشخص کند کدام بخشهای ورودی برای تولید خروجی فعلی اهمیت بیشتری دارند.
همین سازوکار یکی از دلایلی است که مدلهای Transformer میتوانند متنهای پیچیدهتر و مکالمههای طولانیتر را نسبت به بسیاری از معماریهای قدیمی بهتر پردازش کنند.
Context چیست و چرا ChatGPT مکالمه را به خاطر میسپارد؟
اگر به ChatGPT بگویید:
«یک مقاله درباره لپتاپ بنویس.»
و چند پیام بعد بپرسید:
«حالا مقدمهاش را کوتاهتر کن.»
ChatGPT باید بفهمد «مقدمه» مربوط به همان مقاله قبلی است.
این کار به Context یا زمینه مکالمه مربوط میشود.
مدل هنگام تولید پاسخ، فقط پیام آخر شما را در نظر نمیگیرد؛ بلکه اطلاعاتی را که در زمینه قابل دسترس مکالمه قرار دارند نیز پردازش میکند.
البته این زمینه نامحدود نیست. هر مدل ظرفیت مشخصی برای پردازش اطلاعات در یک نوبت دارد که به آن Context Window گفته میشود.
هرچه مکالمه طولانیتر شود، تعداد توکنهای موجود در زمینه افزایش پیدا میکند و در شرایطی ممکن است برخی اطلاعات قدیمی دیگر در محدودهای که مدل میتواند در همان لحظه استفاده کند، قرار نداشته باشند.
ChatGPT چگونه پاسخ را تولید میکند؟
اینجا به مهمترین قسمت ماجرا میرسیم.
بعد از پردازش درخواست، مدل شروع به تولید خروجی میکند.
اما پاسخ را یکباره تولید نمیکند.
مدل در یک فرایند تکرارشونده، برای بخش بعدی متن احتمالهای مختلفی را محاسبه میکند و سپس یک توکن را انتخاب میکند. توکن جدید به متن خروجی اضافه میشود و مدل دوباره برای توکن بعدی محاسبه انجام میدهد.
این چرخه بارها تکرار میشود:
تحلیل Context → پیشبینی توکن بعدی → اضافه شدن توکن → پردازش دوباره → پیشبینی توکن بعدی
در نهایت مجموعه این توکنها به پاسخ قابل خواندن تبدیل میشود.
به همین دلیل عبارت «ChatGPT کلمهبهکلمه فکر میکند» توضیح دقیقی نیست. بهتر است بگوییم مدل خروجی را بهصورت توکنهای متوالی تولید میکند.
آیا ChatGPT فقط محتملترین کلمه را انتخاب میکند؟
ایده «پیشبینی کلمه بعدی» برای توضیح پایه بسیار مفید است، اما اگر بخواهیم دقیق باشیم، مدل صرفاً یک کلمه را از یک فهرست انتخاب نمیکند.
مدل برای توکنهای مختلف احتمالهایی محاسبه میکند و فرایند تولید با تنظیمات و روشهای نمونهگیری مختلف میتواند باعث شود خروجی دقیقاً یکسان نباشد.
به همین دلیل ممکن است یک سؤال را دو بار بپرسید و پاسخهایی با ساختار یا کلمات متفاوت دریافت کنید.
این تفاوت لزوماً به معنی تغییر دانش مدل نیست؛ بخشی از آن به نحوه تولید احتمالی پاسخ مربوط میشود.
ChatGPT چگونه آموزش میبیند؟
پاسخی که ChatGPT در چند ثانیه تولید میکند نتیجه یک فرایند آموزشی بسیار طولانی است.
در سادهترین تصویر، میتوان آموزش مدل را در چند مرحله در نظر گرفت.
۱. پیشآموزش یا Pre-training
در مرحله پیشآموزش، مدل با حجم بسیار بزرگی از دادهها مواجه میشود و تلاش میکند الگوهای موجود در آنها را یاد بگیرد.
مدل بارها و بارها با مسئله پیشبینی توکن بعدی مواجه میشود و پارامترهای داخلی آن برای بهبود پیشبینی تنظیم میشوند.
در نتیجه، مدل بهتدریج الگوهای مربوط به زبان، ساختار جمله، ارتباط مفاهیم و بسیاری از روابط موجود در دادههای آموزشی را یاد میگیرد.
این مرحله به مدل کمک میکند پایه گستردهای از قابلیتهای زبانی ایجاد کند.
۲. پسآموزش و تنظیم مدل
یک مدل خام که فقط روی حجم زیادی از متن آموزش دیده باشد، الزاماً دستیار خوبی نیست.
ممکن است بتواند متن را ادامه دهد، اما لزوماً نمیداند چگونه به یک دستور پاسخ مناسب بدهد، چگونه پاسخ را ساختاربندی کند یا چه نوع درخواستهایی را نباید انجام دهد.
به همین دلیل مراحل دیگری برای بهبود رفتار مدل انجام میشود.
در این مراحل میتوان از نمونههای انسانی، ارزیابی پاسخها، روشهای نظارتشده و تکنیکهای مختلف پسآموزش استفاده کرد.
۳. بازخورد انسانی و همراستاسازی
روشهایی مانند RLHF یا یادگیری تقویتی از بازخورد انسانی در نسلهای مختلف مدلهای مکالمهای برای نزدیکتر کردن رفتار مدل به ترجیحات انسانی استفاده شدهاند.
ایده کلی این است که انسانها کیفیت پاسخهای مختلف را ارزیابی میکنند و این بازخورد برای بهبود رفتار مدل مورد استفاده قرار میگیرد.
هدف چنین فرایندهایی فقط «دانش بیشتر» نیست؛ بلکه مواردی مانند دنبال کردن دستور، مفید بودن، کیفیت پاسخ، ایمنی و نحوه تعامل نیز اهمیت دارند.
نکته مهم این است که نباید تصور کرد همه مدلهای جدید ChatGPT دقیقاً با یک روش آموزشی یکسان ساخته میشوند. روشهای آموزش و پسآموزش مدلهای جدید پیچیدهتر و متنوعتر شدهاند.
پارامترهای مدل چه هستند؟
یکی دیگر از مفاهیم مهم در مدلهای زبانی، Parameter یا پارامتر است.
پارامترها را میتوان مقادیر عددی داخلی مدل دانست که در زمان آموزش تنظیم میشوند.
مدل هنگام آموزش تلاش میکند این مقادیر را طوری تغییر دهد که بتواند الگوهای موجود در دادهها را بهتر تشخیص دهد و پیشبینیهای بهتری انجام دهد.
به زبان ساده، اگر آموزش را فرایند یادگیری مدل در نظر بگیریم، پارامترها بخشی از مقادیری هستند که در جریان این یادگیری تغییر میکنند.
البته تعداد پارامترها بهتنهایی معیار کاملی برای قدرت یک مدل نیست. معماری، کیفیت داده، روش آموزش، پسآموزش و شیوه استفاده از مدل نیز اهمیت زیادی دارند.
Inference چیست؟
وقتی آموزش مدل تمام شده و شما سؤال خود را وارد میکنید، مدل دیگر در حال آموزش کامل از ابتدا نیست.
مرحلهای که مدل آموزشدیده درخواست شما را پردازش کرده و خروجی تولید میکند، Inference یا استنتاج نام دارد.
در این مرحله مدل از پارامترهای آموزشدیده، ورودی فعلی و Context موجود استفاده میکند تا پاسخ تولید شود.
به همین دلیل است که پرسیدن یک سؤال جدید از ChatGPT به این معنا نیست که مدل همان لحظه از صفر در حال یادگیری آن موضوع است.
آیا ChatGPT با هر سؤال جدید یاد میگیرد؟
بهصورت ساده، خیر.
وقتی از ChatGPT سؤال میپرسید، مدل برای پاسخ دادن به آن سؤال بهطور کامل دوباره آموزش نمیبیند.
در عوض، از مدل آموزشدیده و اطلاعات موجود در Context استفاده میکند و پاسخ جدید را تولید میکند.
البته موضوع استفاده از مکالمات برای بهبود مدلهای آینده، تنظیمات داده و حریم خصوصی بحث جداگانهای است و نباید آن را با «یادگیری لحظهای مدل هنگام چت» یکی دانست.
چرا ChatGPT گاهی جواب اشتباه میدهد؟
یکی از مهمترین نکات درباره نحوه کار ChatGPT همین جا مشخص میشود.
مدل اساساً برای تولید پاسخهای مناسب و محتمل آموزش دیده است، نه اینکه برای هر جمله بهصورت خودکار یک منبع مستقل را بررسی و حقیقت آن را تأیید کند.
در نتیجه ممکن است پاسخی:
- بسیار روان باشد
- ساختار خوبی داشته باشد
- کاملاً مطمئن به نظر برسد
- اما بخشی از آن اشتباه باشد
این پدیده معمولاً با اصطلاح Hallucination یا توهم هوش مصنوعی شناخته میشود.
برای همین نباید روان بودن پاسخ را با درست بودن آن اشتباه گرفت.
برای اطلاعات حساس، عددهای مهم، اخبار جدید، مسائل حقوقی، مالی، پزشکی یا هر موضوعی که صحت آن اهمیت زیادی دارد، بررسی منبع اصلی ضروری است.
آیا ChatGPT واقعاً فکر میکند؟
یکی از رایجترین سوءبرداشتها این است که چون ChatGPT مانند انسان صحبت میکند، پس حتماً مانند انسان فکر میکند.
اما چنین نتیجهای درست نیست.
مدلهای زبانی الگوهای بسیار پیچیدهای را در دادهها یاد میگیرند و میتوانند خروجیهایی تولید کنند که شبیه استدلال، توضیح یا گفتوگوی انسانی به نظر برسد.
اما این موضوع بهتنهایی به معنی داشتن آگاهی، احساسات یا تجربه انسانی نیست.
بهتر است ChatGPT را یک سیستم محاسباتی بسیار پیشرفته برای پردازش و تولید اطلاعات در نظر بگیریم، نه یک انسان دیجیتال.
آیا ChatGPT پاسخ را از اینترنت پیدا میکند؟
در حالت عادی باید میان تولید پاسخ توسط مدل و جستوجوی وب تفاوت قائل شویم.
مدل زبانی پاسخ را بر اساس الگوهای آموختهشده و Context تولید میکند.
اما در قابلیتهایی که جستوجوی وب در دسترس است، ChatGPT میتواند از ابزار جستوجو برای پیدا کردن اطلاعات جدید استفاده کند و سپس آن اطلاعات را در فرایند پاسخگویی وارد کند.
بنابراین ChatGPT امروزی را نباید صرفاً یک «مدل بدون ابزار» تصور کرد.
در عین حال، حتی زمانی که ابزارهای خارجی در اختیار آن قرار میگیرند، باید بین مدل تولیدکننده پاسخ و ابزار دریافت اطلاعات تفاوت قائل شد.
تفاوت ChatGPT با موتور جستوجو چیست؟
یک موتور جستوجوی سنتی عمدتاً صفحات و منابع موجود را پیدا و رتبهبندی میکند.
ChatGPT میتواند پاسخ را به شکل یک متن جدید تولید کند.
بهصورت ساده:
| موتور جستوجو | ChatGPT |
|---|---|
| صفحات و منابع موجود را پیدا میکند | پاسخ را با استفاده از مدل تولید میکند |
| برای کشف اطلاعات جدید بسیار مناسب است | برای توضیح، خلاصهسازی و تولید محتوا بسیار کاربردی است |
| معمولاً فهرستی از لینکها ارائه میکند | میتواند پاسخ مکالمهای ارائه دهد |
| کیفیت پاسخ به منابع پیدا شده وابسته است | کیفیت پاسخ به مدل، Context، ابزارها و ورودی وابسته است |
| برای اطلاعات لحظهای بهطور طبیعی مناسب است | در صورت وجود قابلیت جستوجو میتواند اطلاعات جدید دریافت کند |
در عمل، این دو فناوری میتوانند مکمل یکدیگر باشند.
ChatGPT چگونه میتواند تصویر و فایل را پردازش کند؟
ChatGPT امروزی فقط محدود به متن نیست.
در قابلیتهای پشتیبانیشده، سیستم میتواند ورودیهایی مانند تصویر، فایل و صدا را نیز پردازش کند.
ایده بنیادی همچنان مشابه است: اطلاعات ورودی باید به شکلی تبدیل شوند که مدل بتواند آنها را پردازش کند.
به همین دلیل، وقتی تصویری را برای تحلیل ارسال میکنید، سیستم فقط «عکس را مثل چشم انسان نمیبیند»؛ بلکه اطلاعات تصویری را به نمایشهایی تبدیل میکند که مدل بتواند روی آنها پردازش انجام دهد.
این همان مسیری است که ChatGPT را از یک چتبات متنی ساده به یک سیستم چندوجهی نزدیک کرده است.
چرا ChatGPT میتواند کارهای مختلفی انجام دهد؟
شاید جالبترین بخش ماجرا این باشد که یک مدل زبانی چگونه میتواند هم مقاله بنویسد، هم کد تولید کند، هم متن را خلاصه کند و هم یک مفهوم پیچیده را توضیح دهد.
دلیل اصلی این است که مدل در طول آموزش فقط یک مجموعه پاسخ مشخص را حفظ نمیکند؛ بلکه الگوهای بسیار متنوعی از زبان، ساختار، کد و اطلاعات را یاد میگیرد.
وقتی کاربر درخواست جدیدی ارائه میکند، مدل تلاش میکند الگوهای آموختهشده را با Context و دستور جدید ترکیب کند.
به همین دلیل یک مدل واحد میتواند در وظایف بسیار متفاوتی مورد استفاده قرار بگیرد.
یک مثال ساده از نحوه کار ChatGPT
فرض کنید از ChatGPT میپرسید:
«برای یک دانشآموز ۱۲ ساله توضیح بده چرا آسمان آبی است.»
تقریباً میتوان فرایند را اینگونه تصور کرد:
۱. دریافت درخواست
سیستم متن شما را دریافت میکند.
۲. Tokenization
جمله به توکنهای قابل پردازش تبدیل میشود.
۳. تبدیل به نمایش عددی
توکنها به شکلهایی تبدیل میشوند که شبکه عصبی بتواند آنها را پردازش کند.
۴. پردازش Context
مدل متوجه میشود که مخاطب یک دانشآموز ۱۲ ساله است و پاسخ باید ساده باشد.
۵. پردازش Transformer و Attention
مدل ارتباط میان بخشهای مختلف درخواست را بررسی میکند.
۶. تولید خروجی
مدل شروع به پیشبینی توکنهای مناسب برای پاسخ میکند.
۷. تکرار
این فرایند برای توکنهای بعدی ادامه پیدا میکند.
۸. نمایش پاسخ
در نهایت توکنهای تولیدشده به متن قابل خواندن تبدیل میشوند.
همه این مراحل در مدت کوتاهی انجام میشوند؛ به همین دلیل نتیجه نهایی برای کاربر شبیه یک پاسخ فوری به نظر میرسد.
آیا هرچه مدل بزرگتر باشد، همیشه بهتر است؟
نه لزوماً.
بزرگتر بودن مدل میتواند مزایایی داشته باشد، اما کیفیت یک مدل فقط به تعداد پارامترها وابسته نیست.
مواردی مانند:
- معماری مدل
- کیفیت دادههای آموزشی
- روش آموزش
- پسآموزش
- کیفیت دادههای ارزیابی
- روش استفاده از ابزارها
- توانایی استدلال
- Context Window
- بهینهسازی برای سرعت و هزینه
همگی میتوانند روی عملکرد نهایی تأثیر بگذارند.
به همین دلیل مقایسه مدلها فقط بر اساس یک عدد مانند تعداد پارامترها میتواند گمراهکننده باشد.
چرا فهمیدن نحوه کار ChatGPT مهم است؟
شاید در نگاه اول دانستن اینکه Token یا Transformer چیست فقط یک موضوع فنی به نظر برسد، اما در عمل درک سازوکار ChatGPT باعث میشود بهتر از آن استفاده کنید.
وقتی بدانید مدل:
- پاسخ را از یک بانک جواب آماده بیرون نمیکشد
- به Context وابسته است
- خروجی را مرحلهبهمرحله تولید میکند
- ممکن است اطلاعات نادرست تولید کند
- برای اطلاعات جدید ممکن است به ابزار جستوجو نیاز داشته باشد
- با دستور دقیقتر معمولاً خروجی مناسبتری میگیرد
انتظار واقعبینانهتری از آن خواهید داشت.
در واقع، شناخت نحوه کار ChatGPT کمک میکند بدانیم چه زمانی باید به آن اعتماد کنیم و چه زمانی باید پاسخ را بررسی کنیم.
جمعبندی؛ ChatGPT چگونه کار میکند؟
ChatGPT حاصل کنار هم قرار گرفتن چند فناوری مهم در هوش مصنوعی است. در هسته این فرایند، مدلهای زبانی بزرگ، شبکههای عصبی، معماری Transformer، Tokenization، Attention، پارامترهای آموزشدیده و فرایند Inference قرار دارند.
وقتی سؤال خود را وارد میکنید، متن به توکن تبدیل میشود، مدل ارتباط میان این توکنها و Context را بررسی میکند و سپس با استفاده از الگوهایی که در زمان آموزش یاد گرفته، خروجی را بهصورت توکنهای متوالی تولید میکند.
بنابراین اگر بخواهیم کل ماجرا را در یک جمله خلاصه کنیم:
ChatGPT پاسخ را از یک فهرست آماده پیدا نمیکند؛ بلکه با استفاده از یک مدل آموزشدیده، Context موجود و در صورت دسترسی ابزارهای خارجی، پاسخ را در لحظه تولید میکند.
همین فرایند ساده به نظر میرسد، اما در پشت آن حجم بسیار بزرگی از محاسبات و فناوریهای پیشرفته هوش مصنوعی قرار دارد.
سوالات متداول
ChatGPT چگونه جواب تولید میکند؟
ChatGPT ورودی را به توکن تبدیل میکند، آنها را با استفاده از مدل و Context پردازش میکند و سپس خروجی را بهصورت توکنهای متوالی تولید میکند.
آیا ChatGPT پاسخها را از یک دیتابیس کپی میکند؟
خیر. مدل زبانی به شکل یک بانک پرسشوپاسخ ساده عمل نمیکند. مدل در زمان آموزش الگوهای موجود در دادهها را یاد میگیرد و هنگام پاسخگویی از این الگوها برای تولید خروجی استفاده میکند.
Transformer در ChatGPT چیست؟
Transformer معماری شبکه عصبی مهمی است که به مدل اجازه میدهد روابط میان بخشهای مختلف ورودی را پردازش کند. Attention یکی از اجزای مهم این معماری است.
Token در ChatGPT چیست؟
توکن واحدی از متن است که مدل آن را پردازش میکند. یک توکن ممکن است یک کلمه، بخشی از یک کلمه یا علامت نگارشی باشد.
آیا ChatGPT با هر سؤال دوباره آموزش میبیند؟
خیر. پاسخ دادن به یک سؤال به معنی آموزش کامل دوباره مدل نیست. در زمان پاسخگویی، مدل آموزشدیده از پارامترها و Context موجود برای تولید خروجی استفاده میکند.
چرا ChatGPT گاهی اطلاعات اشتباه میدهد؟
چون هدف مدل تولید یک پاسخ مناسب و محتمل است و این فرایند بهتنهایی تضمین نمیکند تمام ادعاهای پاسخ با یک منبع واقعی بررسی شده باشند. بنابراین پاسخهای مهم باید بررسی شوند.
آیا ChatGPT مثل انسان فکر میکند؟
خیر، نباید توانایی تولید زبان و پاسخهای پیچیده را با آگاهی یا تفکر انسانی یکی دانست. مدل از محاسبات و الگوهای آموختهشده برای تولید خروجی استفاده میکند.
آیا ChatGPT به اینترنت دسترسی دارد؟
بسته به قابلیتها و حالت استفاده، ChatGPT میتواند از ابزارهایی مانند جستوجوی وب استفاده کند. اما تولید پاسخ توسط مدل با جستوجوی اینترنت یک فرایند یکسان نیست.
آیا ChatGPT فقط برای تولید متن ساخته شده است؟
خیر. نسخهها و قابلیتهای جدید ChatGPT میتوانند با انواع مختلف ورودی و ابزارها کار کنند و قابلیتهای چندوجهی مانند پردازش تصویر، صدا و فایل نیز در تجربههای پشتیبانیشده وجود دارند.
این محتوا بر اساس راهنمای رسمی edoxi و memeburn و coursiv و zapiert ، تهیه و بازنویسی شده است.