هوش مصنوعی چگونه کار میکند؟ از داده تا مدل AI
هوش مصنوعی چگونه کار میکند؟ از داده تا مدل AI
هوش مصنوعی برای بسیاری از کاربران شبیه یک جعبه سیاه است؛ چیزی به آن میگوییم و چند ثانیه بعد جواب، تصویر، کد یا پیشبینی تحویل میگیریم. اما پشت این ظاهر ساده، فرایندی چندمرحلهای از داده، الگوریتم، آموزش مدل و تولید خروجی قرار دارد.

مطالب مشابه: Google Gemini چیست و چه کاربردی دارد؟ راهنمای کامل قابلیتهای Gemini

وقتی از ChatGPT سؤال میپرسید، گوشی با تشخیص چهره قفل میشود، فروشگاه اینترنتی محصولی را پیشنهاد میدهد یا یک سرویس موسیقی آهنگی را برای شما انتخاب میکند، یک سیستم هوش مصنوعی در حال پردازش داده و تشخیص الگو است.
مطالب مشابه : آموزش ساخت ویدیو با هوش مصنوعی Veo 3؛ از ایده تا ویدیوی حرفهای
اما سؤال اصلی این است:

هوش مصنوعی دقیقاً چگونه کار میکند؟
برای فهم آن لازم نیست متخصص کامپیوتر باشید. در این مقاله، مسیر کار AI را از زمانی که داده وارد سیستم میشود تا زمانی که مدل یک پاسخ یا پیشبینی تولید میکند، مرحلهبهمرحله و به زبان ساده بررسی میکنیم.
هوش مصنوعی در یک جمله چگونه کار میکند؟
اگر بخواهیم کل فرایند را بسیار ساده کنیم:
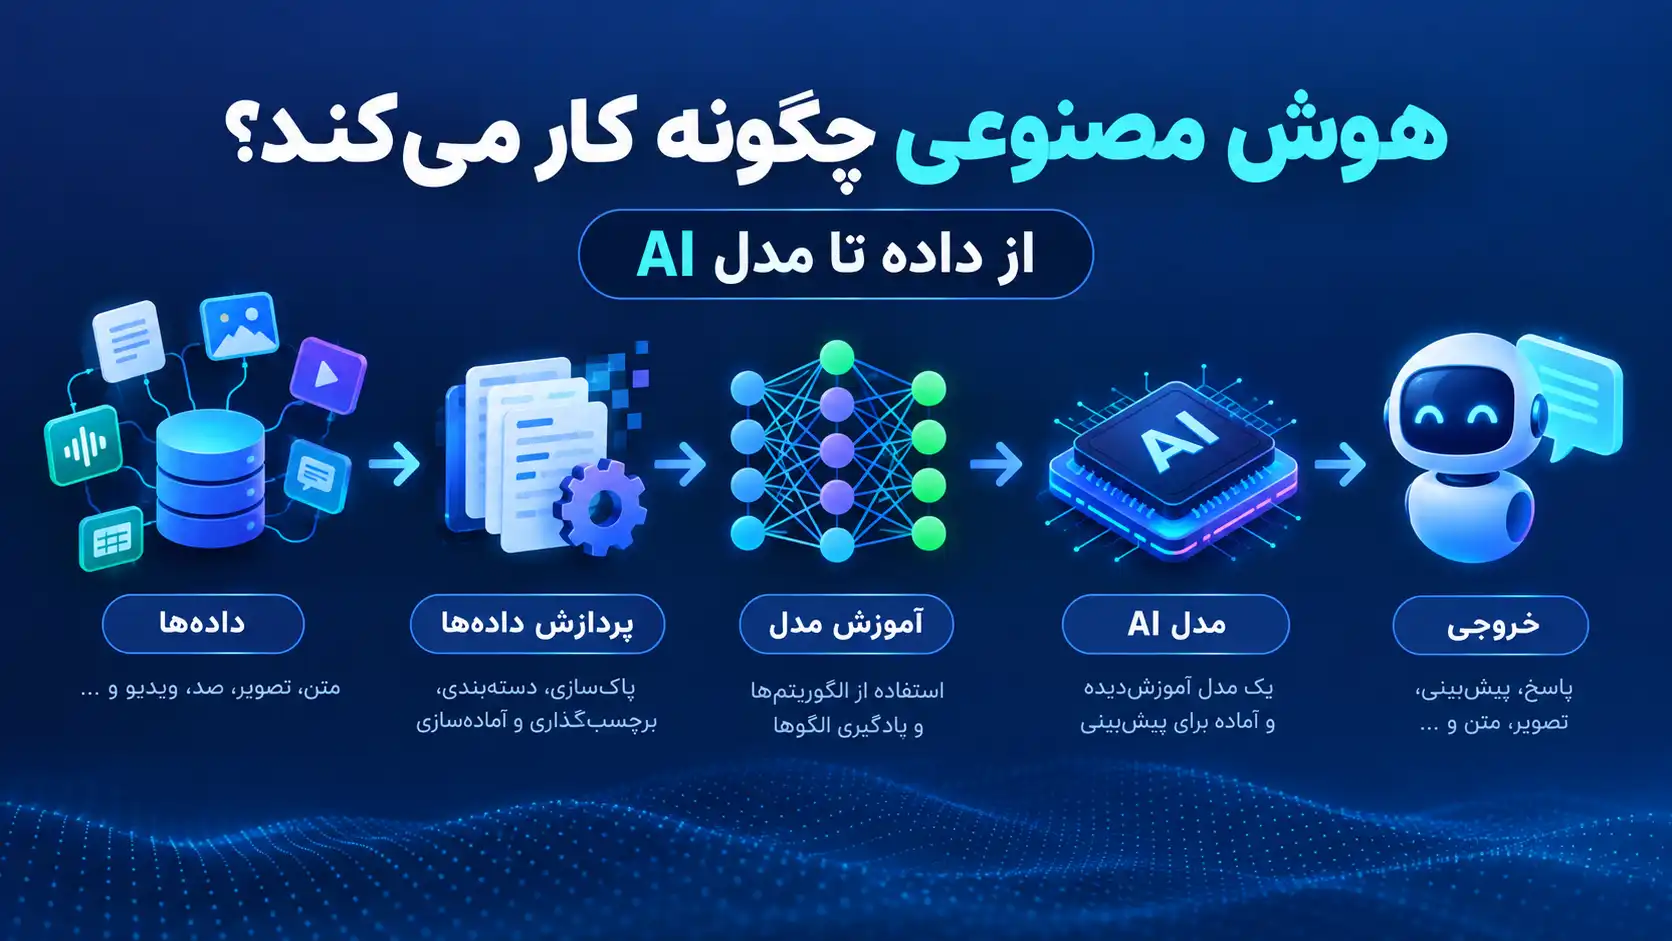
داده → پردازش → آموزش → مدل → ورودی جدید → پیشبینی یا تولید خروجی
برای مثال، فرض کنید میخواهیم سیستمی بسازیم که تصاویر گربه را تشخیص دهد.
ابتدا تعداد زیادی تصویر در اختیار سیستم قرار میدهیم. مدل از این نمونهها الگوهایی مانند شکل، بافت و ویژگیهای تصویری را یاد میگیرد. سپس وقتی تصویری جدید به آن میدهیم، ویژگیهای آن را با الگوهای آموختهشده مقایسه میکند و احتمال میدهد تصویر مربوط به گربه است یا خیر.
البته مدلهای مدرن، مخصوصاً مدلهای زبانی بزرگ، بسیار پیچیدهتر از این مثال ساده هستند؛ اما ایده اصلی همچنان به یادگیری الگو از داده و استفاده از آن برای تولید خروجی برمیگردد.
هوش مصنوعی برای کار کردن به چه چیزهایی نیاز دارد؟
یک سیستم AI معمولاً از چند جزء مهم تشکیل میشود:
- داده
- الگوریتم
- مدل
- پارامترها
- توان پردازشی
- فرایند آموزش
- فرایند استنتاج یا Inference
هرکدام نقش متفاوتی دارند.
داده چیست؟
داده همان چیزی است که سیستم از آن یاد میگیرد یا برای تولید نتیجه از آن استفاده میکند.
داده میتواند شامل موارد مختلفی باشد:
- متن
- تصویر
- صدا
- ویدیو
- اعداد
- اطلاعات حسگرها
- رفتار کاربران
- اسناد و فایلها
برای مثال، اگر بخواهیم مدلی برای تشخیص ایمیلهای اسپم بسازیم، میتوانیم تعداد زیادی ایمیل سالم و اسپم در اختیار مدل قرار دهیم.
اگر دادهها ناقص، اشتباه یا جانبدارانه باشند، کیفیت خروجی مدل نیز میتواند تحت تأثیر قرار بگیرد.
به زبان ساده:
مدل خوب با داده ضعیف الزاماً خروجی خوب تولید نمیکند.
الگوریتم در هوش مصنوعی چه کاری انجام میدهد؟
الگوریتم را میتوان مجموعهای از روشها و دستورهای ریاضی دانست که به سیستم میگویند چگونه از داده یاد بگیرد یا چگونه آن را پردازش کند.
اما الگوریتم با مدل یکی نیست.
بهصورت ساده:
الگوریتم = روش یادگیری
مدل = نتیجهای که پس از یادگیری به وجود آمده است
برای مثال، الگوریتم میتواند روشی را برای پیدا کردن الگو در داده تعیین کند و مدل، ساختاری باشد که پس از آموزش با آن دادهها، بتواند روی ورودیهای جدید کار کند.
مدل هوش مصنوعی چیست؟
مدل را میتوان هستهای دانست که الگوهای موجود در داده را یاد گرفته و بعد از آموزش میتواند روی دادههای جدید کار کند.
مدل میتواند برای کارهای مختلف ساخته شود؛ از تشخیص تصویر و پیشبینی عدد گرفته تا تولید متن، صدا یا تصویر.
برای مثال:
- مدل تشخیص تصویر میتواند اشیا را شناسایی کند.
- مدل پیشبینی میتواند احتمال یک اتفاق را تخمین بزند.
- مدل زبانی میتواند متن را پردازش و تولید کند.
- مدل مولد تصویر میتواند از یک توضیح متنی، تصویر بسازد.
پس وقتی میگوییم «یک AI مدل دارد»، منظور فقط یک فایل ساده یا برنامه معمولی نیست؛ بلکه نتیجه فرایند آموزش روی داده و تنظیم پارامترهای مدل است.
آموزش مدل هوش مصنوعی چگونه انجام میشود؟
حالا به مهمترین بخش میرسیم: Training یا آموزش.
در مرحله آموزش، مدل با نمونههای زیادی مواجه میشود و تلاش میکند الگوهای موجود در آنها را یاد بگیرد.
یک مثال ساده را در نظر بگیرید.
فرض کنید میخواهیم مدلی بسازیم که گربه و سگ را تشخیص دهد.
در اختیار مدل قرار میدهیم:
- تصویر گربه + برچسب «گربه»
- تصویر سگ + برچسب «سگ»
- تصویر گربه + برچسب «گربه»
- تصویر سگ + برچسب «سگ»
مدل ابتدا ممکن است اشتباهات زیادی داشته باشد.
اما با تکرار فرایند آموزش، پارامترهای خود را تغییر میدهد تا خطای پیشبینی کاهش پیدا کند.
در نهایت مدل میتواند تصویر جدیدی را که قبلاً ندیده است دریافت کند و براساس الگوهایی که یاد گرفته، پیشبینی انجام دهد.

پارامترهای مدل چه هستند؟
یکی از مفاهیم مهم در AI، Parameter یا پارامتر است.
پارامترها را میتوان تنظیمات داخلی مدل دانست که در جریان آموزش تغییر میکنند.
در شبکههای عصبی، تعداد بسیار زیادی از این پارامترها میتوانند وجود داشته باشند.
مدل در طول آموزش این مقادیر را تنظیم میکند تا خروجیهایش به نتیجه مورد انتظار نزدیکتر شوند.
یک تشبیه ساده:
فرض کنید صدها پیچ تنظیم در یک دستگاه دارید. در ابتدا هیچکدام دقیق تنظیم نشدهاند. مدل با مشاهده داده و اندازهگیری خطا، این تنظیمات را بهتدریج تغییر میدهد تا عملکرد بهتر شود.
البته این فقط یک تشبیه ساده است و فرایند واقعی آموزش از نظر ریاضی بسیار پیچیدهتر است.
شبکه عصبی چیست؟
بخش بزرگی از هوش مصنوعی مدرن به Neural Network یا شبکه عصبی مصنوعی وابسته است.
شبکه عصبی از لایههایی تشکیل میشود که اطلاعات را پردازش میکنند.
در یک تصویر ساده میتوان آن را اینطور تصور کرد:
ورودی → لایههای پردازشی → خروجی
هر لایه میتواند ویژگیهایی از داده را استخراج یا ترکیب کند.
در پردازش تصویر، لایههای اولیه ممکن است ویژگیهای سادهتری را تشخیص دهند و لایههای عمیقتر ترکیب پیچیدهتری از آن ویژگیها را یاد بگیرند.
در شبکههای عصبی عمیق، تعداد زیادی لایه روی یکدیگر قرار میگیرند؛ به همین دلیل به این حوزه Deep Learning یا یادگیری عمیق گفته میشود.
Backpropagation چگونه به AI یاد میدهد؟
یکی از مفاهیم مهم در آموزش شبکههای عصبی Backpropagation یا پسانتشار خطا است.
مدل ابتدا یک خروجی تولید میکند.
سپس خروجی با نتیجه مورد انتظار مقایسه میشود و میزان خطا مشخص میشود.
بعد سیستم تلاش میکند مشخص کند پارامترهای مختلف مدل چقدر در ایجاد این خطا نقش داشتهاند و آنها را برای مرحله بعد تنظیم میکند.
این چرخه بارها تکرار میشود:
پیشبینی → محاسبه خطا → اصلاح پارامترها → پیشبینی دوباره
با تکرار این فرایند، مدل میتواند عملکرد خود را روی دادههای آموزشی بهتر کند.
یادگیری ماشین چه تفاوتی با هوش مصنوعی دارد؟
AI و Machine Learning یک مفهوم نیستند.
هوش مصنوعی حوزه گستردهتری است که هدف آن ساخت سیستمهایی با قابلیت انجام وظایفی است که به نوعی از تواناییهای هوشمندانه نیاز دارند.
یادگیری ماشین یکی از روشهای مهم برای ساخت چنین سیستمهایی است.
در یادگیری ماشین، مدل به جای اینکه تمام قوانین بهصورت دستی برای آن نوشته شود، از دادهها الگو یاد میگیرد.
به همین دلیل است که بسیاری از سیستمهای AI امروزی میتوانند با دادههای جدید، الگوهای پیچیده را شناسایی کنند.
یادگیری عمیق چیست؟
Deep Learning یا یادگیری عمیق، یکی از شاخههای یادگیری ماشین است که از شبکههای عصبی چندلایه استفاده میکند.
این فناوری نقش مهمی در پیشرفت حوزههایی مانند:
- تشخیص تصویر
- تشخیص گفتار
- ترجمه
- پردازش زبان
- تولید تصویر
- تولید متن
- سیستمهای توصیهگر
داشته است.
مدلهای پیشرفتهای که امروز در ابزارهای مولد AI استفاده میشوند نیز به معماریها و روشهای یادگیری عمیق متکی هستند.
هوش مصنوعی بعد از آموزش چگونه پاسخ میدهد؟
بعد از اینکه مدل آموزش دید، وارد مرحلهای میشویم که معمولاً Inference یا استنتاج نامیده میشود.
در این مرحله دیگر هدف اصلی آموزش مدل نیست؛ بلکه مدل از چیزهایی که در آموزش یاد گرفته برای پردازش یک ورودی جدید استفاده میکند.
مثلاً:
ورودی: یک تصویر جدید
مدل: بررسی الگوهای موجود در تصویر
خروجی: احتمال اینکه تصویر مربوط به گربه باشد
یا در یک مدل زبانی:
ورودی: «برای سفر چه چیزهایی لازم دارم؟»
مدل: پردازش متن و زمینه
خروجی: تولید پاسخ متنی
به همین دلیل، آموزش و استفاده از مدل دو مرحله متفاوت هستند.
ChatGPT چگونه کار میکند؟
مدلهای زبانی بزرگ یا LLM یکی از مهمترین نمونههای AI مدرن هستند.
این مدلها روی حجم بسیار بزرگی از دادههای متنی آموزش میبینند و الگوهای موجود در زبان را یاد میگیرند.
به زبان ساده، یکی از کارهای اساسی مدلهای زبانی، پیشبینی ادامه مناسب یک توالی از توکنها است.
برای مثال اگر ورودی شامل جملهای باشد که با «امروز هوا…» شروع شده، مدل براساس الگوهایی که یاد گرفته، احتمال ادامههای مختلف را محاسبه میکند.
البته مدلهای جدید فقط یک «پیشبینیکننده کلمه بعدی» ساده نیستند؛ معماری، آموزش، تنظیم و قابلیتهای آنها بسیار پیچیدهتر است.
اما این توضیح ساده کمک میکند بفهمیم چرا مدل میتواند متن تولید کند.
توکن چیست؟
مدلهای زبانی معمولاً متن را مستقیماً به شکل کلمههای کامل دریافت نمیکنند.
متن ابتدا به واحدهایی به نام Token تبدیل میشود.
یک توکن ممکن است یک کلمه، بخشی از یک کلمه، عدد، نشانه یا ترکیبی از چند کاراکتر باشد.
سپس مدل با این توکنها کار میکند.
برای همین است که در مدلهای زبانی، مفهوم «تعداد توکن» اهمیت زیادی دارد و میتواند با محدودیت طول ورودی و خروجی ارتباط داشته باشد.
چرا AI گاهی جواب اشتباه میدهد؟
اگر هوش مصنوعی از داده و الگو یاد میگیرد، چرا همیشه درست جواب نمیدهد؟
چون AI یک ماشین حقیقتسنج نیست.
چند عامل میتوانند باعث خطا شوند:
داده نامناسب
اگر داده آموزشی ناقص یا دارای خطا باشد، مدل ممکن است الگوهای نامناسبی یاد بگیرد.
محدودیت مدل
هر مدل تواناییها و محدودیتهای خاص خودش را دارد.
ورودی نامناسب
اگر سؤال مبهم باشد، احتمال خروجی نامناسب افزایش پیدا میکند.
توهم در مدلهای زبانی
مدلهای مولد ممکن است گاهی پاسخی تولید کنند که از نظر زبانی کاملاً طبیعی و قانعکننده است، اما از نظر واقعی نادرست است.
به همین دلیل، پاسخ AI مخصوصاً در موضوعات حساس نباید بدون بررسی پذیرفته شود.
آیا AI واقعاً چیزی را مثل انسان «میفهمد»؟
این سؤال پاسخ سادهای ندارد، اما باید بین پردازش الگوها و تجربه انسانی تفاوت قائل شویم.
مدلهای AI میتوانند اطلاعات بسیار پیچیدهای را پردازش کنند و خروجیهایی تولید کنند که برای انسان شبیه فهمیدن به نظر میرسد.
اما این موضوع به معنی داشتن تجربه انسانی، احساسات یا آگاهی انسانی نیست.
در استفاده روزمره بهتر است AI را سیستمی بسیار قدرتمند برای پردازش اطلاعات، یادگیری الگوها و تولید خروجی بدانیم، نه نسخه دیجیتالی مغز انسان.
هوش مصنوعی چگونه از متن، تصویر و صدا استفاده میکند؟
AI فقط برای متن نیست.
مدلها میتوانند روی انواع مختلف داده کار کنند.
متن
برای:
- ترجمه
- خلاصهسازی
- پاسخگویی
- تولید محتوا
- تحلیل اسناد
تصویر
برای:
- تشخیص اشیا
- تحلیل تصاویر
- تشخیص الگوهای بصری
- تولید تصویر
صدا
برای:
- تبدیل گفتار به متن
- تشخیص صدا
- تولید گفتار
- تحلیل صوت
ویدیو
برای:
- تحلیل محتوای ویدیو
- تشخیص اشیا و رویدادها
- تولید ویدیو
- ترکیب اطلاعات تصویری و صوتی
مدلهای چندوجهی یا Multimodal AI میتوانند چند نوع داده را با هم پردازش کنند؛ مثلاً متن و تصویر را در یک فرایند واحد در نظر بگیرند.
تفاوت AI Model و AI System چیست؟
این دو اصطلاح گاهی بهجای یکدیگر استفاده میشوند، اما دقیقاً یکی نیستند.
AI Model هستهای است که از داده یاد گرفته و میتواند روی ورودیها عملیات انجام دهد.
اما AI System معمولاً مجموعه بزرگتری است که علاوه بر مدل میتواند شامل موارد زیر باشد:
- نرمافزار
- پایگاه داده
- رابط کاربری
- API
- سختافزار
- سیستم امنیتی
- ابزارهای پردازش داده
- مدل یا چند مدل AI
مثلاً یک چتبات فقط یک مدل نیست. ممکن است مدل زبانی، رابط کاربری، سیستم مدیریت گفتگو، پایگاه داده، ابزارهای جستوجو و سرویسهای دیگر در کنار هم یک سیستم کامل را تشکیل دهند.
هوش مصنوعی چگونه از داده خام به خروجی میرسد؟
اگر بخواهیم کل مسیر را در یک مثال ببینیم، یک سیستم تشخیص اسپم میتواند چنین روندی داشته باشد:
مرحله اول: جمعآوری داده
هزاران یا میلیونها نمونه ایمیل جمعآوری میشود.
مرحله دوم: آمادهسازی داده
دادهها پاکسازی و در صورت نیاز برچسبگذاری میشوند.
مرحله سوم: آموزش
مدل با دادهها کار میکند و الگوهای مرتبط با ایمیلهای اسپم را یاد میگیرد.
مرحله چهارم: ارزیابی
مدل با دادههایی که برای ارزیابی کنار گذاشته شدهاند آزمایش میشود.
مرحله پنجم: استقرار
مدل در یک سرویس یا نرمافزار قرار میگیرد.
مرحله ششم: استنتاج
هر ایمیل جدید وارد سیستم میشود و مدل احتمال اسپم بودن آن را تخمین میزند.
این مثال ساده، مسیر کلی بسیاری از سیستمهای یادگیری ماشین را نشان میدهد؛ هرچند پروژههای واقعی میتوانند بسیار پیچیدهتر باشند.
آیا AI بعد از انتشار هم یاد میگیرد؟
این تصور که هر مدل AI بعد از هر سؤال فوراً خودش را آموزش میدهد، درست نیست.
استفاده از یک مدل و آموزش مجدد آن دو فرایند متفاوت هستند.
ممکن است یک سرویس از اطلاعات جدید برای بهبود سیستم استفاده کند، اما این موضوع به معماری، سیاستهای سرویس و روش آموزش آن بستگی دارد.
در بسیاری از سیستمهای حرفهای، مدل ابتدا آموزش داده میشود، سپس در محیط واقعی برای استنتاج استفاده میشود و عملکرد آن با روشهای مختلف پایش و ارزیابی میشود.
در برخی پروژهها نیز مدل میتواند با دادههای جدید Fine-tune شود یا نسخه جدیدی از آن آموزش داده شود.
Fine-tuning چیست؟
Fine-tuning یا تنظیم دقیق یعنی یک مدل از پیشآموزشدیده را با دادههای تخصصیتر برای یک کاربرد مشخص تنظیم کنیم.
برای مثال، یک مدل عمومی ممکن است برای زبان و وظایف مختلف آموزش دیده باشد. سپس میتوان آن را با دادههای تخصصی برای یک کاربرد خاص تنظیم کرد.
این روش میتواند باعث شود مدل برای یک حوزه یا وظیفه مشخص عملکرد مناسبتری داشته باشد.
البته Fine-tuning تنها راه شخصیسازی مدل نیست. روشهایی مانند استفاده از داده خارجی، RAG و طراحی مناسب سیستم نیز میتوانند نقش مهمی داشته باشند.
چرا کیفیت داده اینقدر مهم است؟
یکی از مهمترین اصول در یادگیری ماشین این است:
داده بیکیفیت میتواند به مدل بیکیفیت منجر شود.
اگر داده:
- ناقص باشد
- اشتباه داشته باشد
- بیش از حد محدود باشد
- نماینده مناسبی از مسئله نباشد
- دارای سوگیری باشد
مدل نیز ممکن است نتایج نامناسبی تولید کند.
برای همین در پروژههای واقعی AI، آمادهسازی و ارزیابی داده گاهی به اندازه انتخاب مدل اهمیت دارد.
آیا هرچه مدل بزرگتر باشد، بهتر است؟
نه لزوماً.
یک مدل بزرگتر میتواند توانایی بیشتری داشته باشد، اما معمولاً هزینه، منابع محاسباتی و پیچیدگی بیشتری هم دارد.
برای یک کار ساده ممکن است یک مدل کوچکتر و تخصصیتر نتیجهای مناسبتر و اقتصادیتر ارائه دهد.
انتخاب مدل به عواملی مانند:
- نوع کار
- کیفیت داده
- دقت مورد نیاز
- سرعت
- هزینه
- سختافزار
- حریم خصوصی
- حجم ورودی
بستگی دارد.
بنابراین «بزرگترین مدل» همیشه به معنی «مناسبترین مدل» نیست.
هوش مصنوعی در زندگی روزمره چگونه کار میکند؟
شاید بیشتر از چیزی که تصور میکنید از AI استفاده کنید.
برای مثال:
تشخیص چهره:
سیستم ویژگیهای تصویر چهره را تحلیل میکند و آن را با الگوهای مورد نیاز مقایسه میکند.
پیشنهاد فیلم:
سیستم از رفتار کاربران و ویژگیهای محتوا برای پیشبینی علاقه احتمالی شما استفاده میکند.
فیلتر اسپم:
مدل الگوهای پیامهای ناخواسته را شناسایی میکند.
ترجمه ماشینی:
مدل روابط و الگوهای زبانی را برای تبدیل متن از یک زبان به زبان دیگر استفاده میکند.
دستیارهای صوتی:
صدا به اطلاعات قابل پردازش تبدیل میشود و سیستم تلاش میکند منظور کاربر را تشخیص دهد.
چتباتهای مولد:
مدل ورودی متنی را پردازش کرده و بر اساس الگوهای آموختهشده، خروجی تولید میکند.
آیا هوش مصنوعی همیشه به اینترنت نیاز دارد؟
خیر.
یک مدل AI میتواند روی سرورهای ابری اجرا شود یا در برخی موارد روی کامپیوتر، گوشی یا دستگاه دیگری اجرا شود.
مدلهای ابری معمولاً به زیرساخت قدرتمندتری دسترسی دارند، درحالیکه مدلهای کوچکتر میتوانند برای اجرای محلی یا روی دستگاه طراحی شوند.
البته قابلیتهایی مانند جستوجوی وب یا دسترسی به اطلاعات لحظهای به سیستمهای متصل به اینترنت یا منابع خارجی نیاز دارند.
آینده کار AI به کدام سمت میرود؟
مسیر توسعه AI فقط به بزرگتر کردن مدلها محدود نیست.
در سالهای اخیر توجه زیادی به مواردی مانند:
- مدلهای چندوجهی
- مدلهای کوچکتر و سریعتر
- مدلهای استدلالی
- AI Agentها
- پردازش روی دستگاه
- استفاده از ابزارهای خارجی
- RAG
- بهبود دقت و ارزیابی
- کاهش هزینه اجرای مدل
معطوف شده است.
به همین دلیل، درک اصول پایهای AI حتی برای کاربر عادی هم مهمتر شده است؛ زیرا بسیاری از ابزارهایی که روزانه استفاده میکنیم، در نهایت به همین زنجیره داده → مدل → پردازش → خروجی متکی هستند.
جمعبندی؛ هوش مصنوعی در نهایت چگونه کار میکند؟
اگر بخواهیم تمام مقاله را در چند مرحله خلاصه کنیم:
۱. داده جمعآوری میشود.
۲. داده آماده و پردازش میشود.
۳. الگوریتم مناسب انتخاب میشود.
۴. مدل با دادههای آموزشی آموزش میبیند.
۵. پارامترهای مدل در طول آموزش تنظیم میشوند.
۶. مدل با دادههای جدید ارزیابی میشود.
۷. مدل در یک سیستم مستقر میشود.
۸. ورودی جدید وارد مدل میشود.
۹. مدل با استفاده از الگوهای آموختهشده خروجی تولید میکند.
۱۰. عملکرد سیستم میتواند پایش و در صورت نیاز مدل یا دادهها بهبود داده شوند.
پس برخلاف تصور رایج، هوش مصنوعی یک «ذهن دیجیتال جادویی» نیست. پشت پاسخها و پیشبینیهای آن، مجموعهای از دادهها، الگوریتمها، مدلهای ریاضی، پارامترها، توان پردازشی و فرایندهای آموزش و استنتاج قرار دارد.
شناخت همین مسیر ساده کمک میکند بهتر بفهمیم چرا AI میتواند در بعضی کارها فوقالعاده دقیق باشد و در بعضی موقعیتها نیز اشتباه کند.
سوالات متداول
هوش مصنوعی چگونه یاد میگیرد؟
هوش مصنوعی در بسیاری از سیستمها با استفاده از الگوریتمهای یادگیری ماشین و دادههای آموزشی، الگوهای موجود در داده را یاد میگیرد. مدل با مقایسه خروجی خود با نتیجه مورد انتظار، پارامترهایش را در طول آموزش تنظیم میکند.
مدل هوش مصنوعی چیست؟
مدل AI ساختاری است که با استفاده از داده آموزش دیده و میتواند برای کارهایی مانند پیشبینی، دستهبندی، تشخیص الگو یا تولید محتوا استفاده شود.
تفاوت AI و Machine Learning چیست؟
هوش مصنوعی حوزه گستردهتری است و یادگیری ماشین یکی از روشهای اصلی برای ساخت سیستمهای AI محسوب میشود.
شبکه عصبی چیست؟
شبکه عصبی نوعی مدل محاسباتی است که از لایههای متصل به هم برای پردازش اطلاعات و یادگیری الگوها استفاده میکند. بسیاری از سیستمهای پیشرفته AI بر پایه شبکههای عصبی ساخته شدهاند.
ChatGPT چگونه پاسخ تولید میکند؟
ChatGPT بر پایه مدلهای زبانی بزرگ کار میکند. مدل ورودی کاربر را به واحدهای قابل پردازش تبدیل میکند و سپس بر اساس الگوهایی که در فرایند آموزش یاد گرفته، خروجی متنی تولید میکند.
آیا هوش مصنوعی همیشه جواب درست میدهد؟
خیر. AI ممکن است به دلیل داده نامناسب، محدودیت مدل، ابهام ورودی یا خطاهای ذاتی سیستم، خروجی اشتباه تولید کند. به همین دلیل اطلاعات مهم باید بررسی شوند.
آیا AI بعد از هر سؤال خودش را آموزش میدهد؟
خیر. استفاده از مدل برای پاسخگویی با آموزش مجدد مدل یکسان نیست. بهروزرسانی یا آموزش دوباره یک مدل به فرایندهای جداگانه نیاز دارد.
آیا مدل بزرگتر همیشه بهتر است؟
خیر. مدل مناسب به نوع کار، دقت مورد نیاز، هزینه، سرعت، داده و منابع محاسباتی بستگی دارد. گاهی یک مدل کوچکتر برای یک کار مشخص انتخاب مناسبتری است.
این مطلب بر اساس گزارش وبسایت coursera و azure.microsoft و amquesteducation و thoughtspot بازنویسی شده است.