مدل زبانی بزرگ یا LLM چیست و چگونه کار میکند؟

مدل زبانی بزرگ یا LLM چیست و چگونه کار میکند؟
اگر تاکنون از ChatGPT، Claude، Gemini یا ابزارهای مشابه استفاده کردهاید، احتمالاً با اصطلاح LLM یا Large Language Model روبهرو شدهاید. اما LLM دقیقاً چیست؟ چگونه میتواند سؤال ما را بفهمد، متن بنویسد، ترجمه کند، کد تولید کند یا یک مقاله را خلاصه کند؟

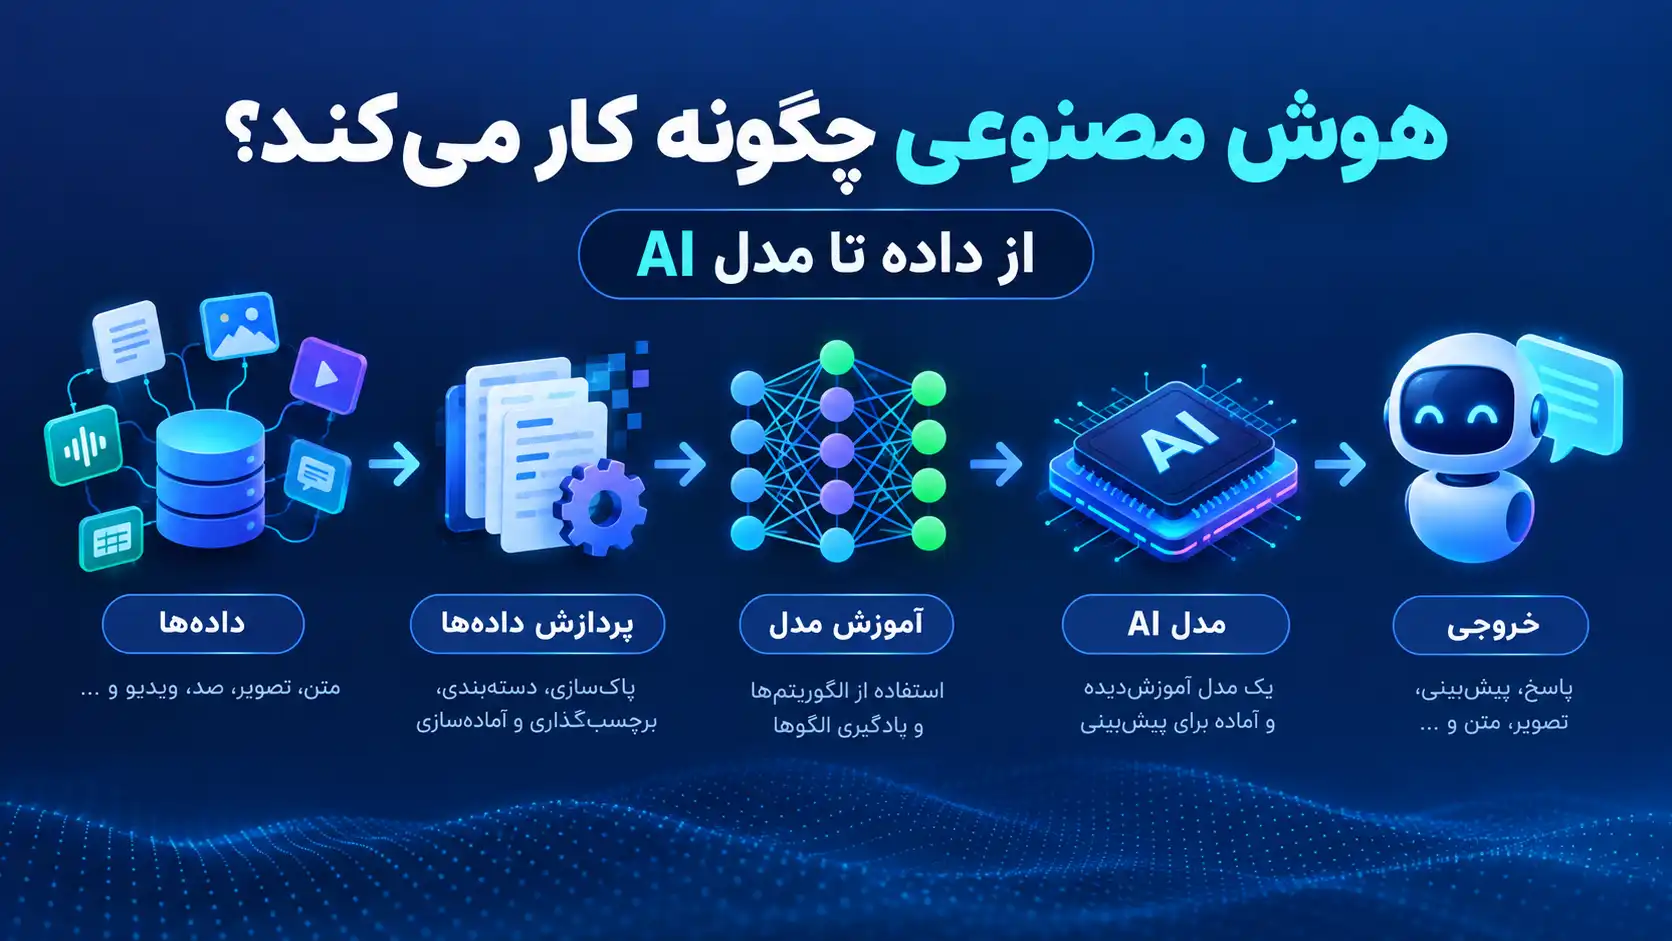
مطالب مشابه: هوش مصنوعی چگونه کار میکند؟ از داده تا مدل AI

مدل زبانی بزرگ یا LLM نوعی مدل هوش مصنوعی است که با حجم بسیار زیادی از دادههای متنی آموزش داده میشود تا الگوهای زبان را یاد بگیرد و بتواند متن را در پاسخ به ورودی کاربر تولید و پردازش کند.
مطالب مشابه: تفاوت هوش مصنوعی، یادگیری ماشین و یادگیری عمیق چیست؟
اما این تعریف ساده، داستان اصلی را کامل توضیح نمیدهد. LLM نه یک پایگاه داده معمولی است و نه یک موتور جستوجو که پاسخها را از یک فهرست آماده بیرون بکشد. این مدلها در فرایند آموزش، الگوهای پیچیدهای میان کلمات، جملهها، مفاهیم و ساختارهای زبانی یاد میگیرند و هنگام دریافت درخواست، بر اساس همین الگوها خروجی تولید میکنند.
در این راهنما از صفر توضیح میدهیم LLM چیست، چگونه آموزش میبیند، Transformer و Token چه نقشی دارند، چرا مدلهای زبانی گاهی اشتباه میکنند و ChatGPT چه ارتباطی با LLM دارد.
LLM چیست؟
LLM مخفف Large Language Model به معنی «مدل زبانی بزرگ» است.
این مدلها زیرمجموعهای از مدلهای یادگیری عمیق هستند که برای پردازش و تولید زبان ساخته شدهاند. آنها با حجم بسیار زیادی از دادهها آموزش میبینند و میتوانند وظایفی مانند تولید متن، پاسخگویی به سؤال، خلاصهسازی، ترجمه، تولید کد و تحلیل زبان را انجام دهند.
کلمه «بزرگ» در LLM فقط به حجم فایل مدل اشاره نمیکند. این اصطلاح به مقیاس مدل، تعداد پارامترهای آن، حجم دادههای آموزشی و میزان محاسبات موردنیاز برای آموزش نیز ارتباط دارد.
در سادهترین بیان:
LLM مدلی است که با دیدن حجم عظیمی از نمونههای زبانی، الگوهای زبان را یاد میگیرد و هنگام دریافت ورودی، خروجی مناسب را بهصورت محاسباتی تولید میکند.
استانفورد نیز LLM را یک سیستم هوش مصنوعی میداند که با حجم بسیار زیادی از دادههای متنی آموزش داده میشود تا زبان انسانی را پردازش و تولید کند. این مدلها میتوانند برای کارهایی مانند پاسخگویی، ترجمه و تولید کد استفاده شوند.
LLM چه تفاوتی با هوش مصنوعی دارد؟
یکی از اشتباهات رایج این است که LLM را با کل هوش مصنوعی یکی بدانیم.
هوش مصنوعی یا AI یک مفهوم بسیار گستردهتر است.
AI میتواند شامل سیستمهایی برای تشخیص تصویر، پردازش صدا، رباتیک، پیشبینی، تحلیل داده، خودروهای خودران و بسیاری از کاربردهای دیگر باشد.
LLM در واقع یکی از انواع مدلهای هوش مصنوعی است که تمرکز اصلی آن روی زبان و دادههای مرتبط با زبان است.
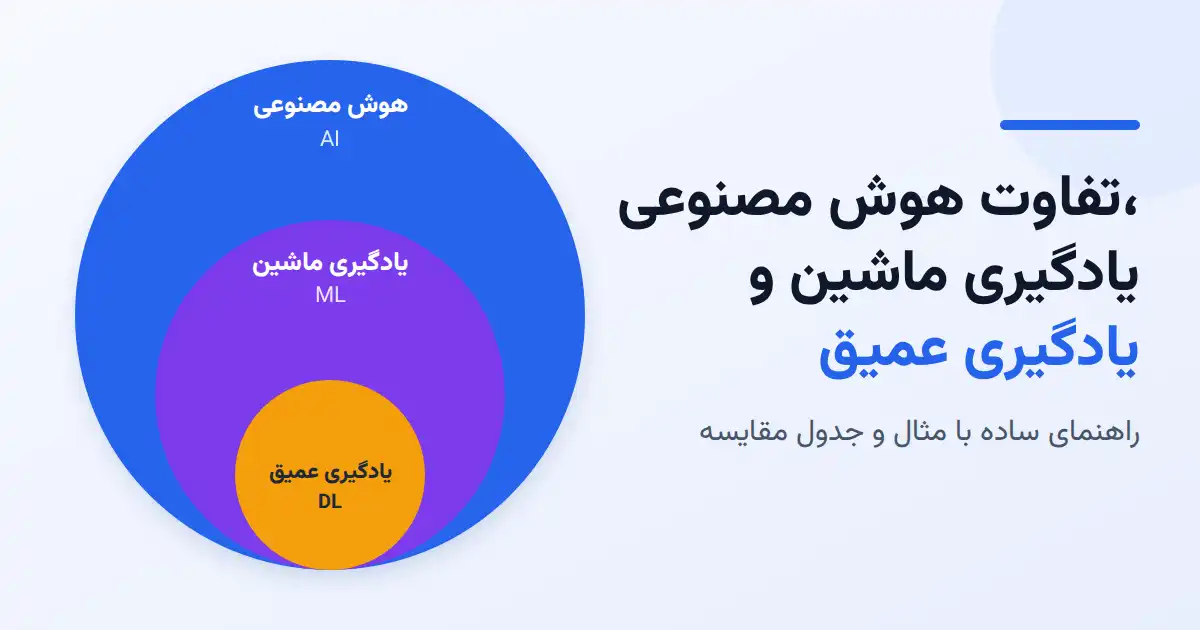
میتوان این رابطه را اینطور تصور کرد:
هوش مصنوعی ← یادگیری ماشین ← یادگیری عمیق ← مدلهای زبانی بزرگ
البته این زنجیره یک نمایش سادهشده است و همه سیستمهای AI دقیقاً در چنین ساختاری قرار نمیگیرند.
LLM چه تفاوتی با ChatGPT دارد؟
این هم یکی از مهمترین ابهامهاست.
LLM یک مدل است؛ ChatGPT یک محصول و رابط کاربری مبتنی بر مدلهای هوش مصنوعی است.
برای درک سادهتر، یک LLM را میتوان موتور اصلی در نظر گرفت و یک سرویس چت را محیطی دانست که کاربر از طریق آن با مدل تعامل میکند.
در یک محصول واقعی، ممکن است علاوه بر مدل زبانی، اجزای دیگری هم وجود داشته باشند؛ مانند ابزارهای جستوجو، حافظه، اتصال به فایلها، ابزارهای کدنویسی، سیستمهای ایمنی، رابط کاربری و سرویسهای خارجی.
بنابراین:
ChatGPT = فقط LLM نیست.
یک سرویس هوش مصنوعی میتواند از LLM در کنار اجزای نرمافزاری دیگر استفاده کند.
LLM چگونه کار میکند؟
برای فهم نحوه کار LLM، بهتر است فرایند را به چند مرحله تقسیم کنیم:
- جمعآوری و آمادهسازی داده
- تبدیل متن به Token
- آموزش مدل
- یادگیری پارامترها
- تنظیم و بهینهسازی مدل
- دریافت Prompt
- تولید خروجی در مرحله Inference
در ظاهر، کاربر فقط یک سؤال مینویسد و پاسخ میگیرد؛ اما پشت این فرایند، حجم زیادی از محاسبات ریاضی انجام میشود.
Token چیست و چرا اهمیت دارد؟
کامپیوتر متن را دقیقاً مانند انسان نمیخواند.
متن ابتدا به واحدهای کوچکتری به نام Token تقسیم میشود. Token میتواند یک کلمه، بخشی از یک کلمه، علامت یا ترکیبی از چند کاراکتر باشد.
برای مثال، یک جمله ممکن است به چندین Token تقسیم شود.
مدل سپس این Tokenها را به نمایشهای عددی تبدیل میکند تا شبکه عصبی بتواند روی آنها محاسبات انجام دهد.
بنابراین وقتی شما یک جمله را در یک چتبات وارد میکنید، مدل ابتدا آن را به شکل قابلپردازش برای شبکه عصبی تبدیل میکند.
چرا تعداد Token مهم است؟
Token فقط برای آموزش مدل مهم نیست.
در زمان استفاده نیز محدودیتهای مختلفی مانند Context Window بر اساس تعداد Tokenها تعریف میشوند.
Context Window مشخص میکند مدل در یک درخواست چه مقدار ورودی و زمینه را میتواند همزمان پردازش کند.
به همین دلیل، وقتی یک سند بسیار طولانی را در اختیار یک مدل قرار میدهید، اندازه متن و ظرفیت Context اهمیت پیدا میکند.
Transformer چیست؟
یکی از مهمترین فناوریهای پشت LLMهای مدرن، معماری Transformer است.
Transformer در سال ۲۰۱۷ معرفی شد و با استفاده از سازوکار Attention توانست ارتباط میان بخشهای مختلف یک دنباله متنی را به شکل مؤثرتری مدل کند.
برای مثال، در یک پاراگراف طولانی، معنی یک کلمه ممکن است به کلماتی وابسته باشد که چندین کلمه یا حتی جمله قبلتر قرار گرفتهاند.
مکانیزم Attention به مدل کمک میکند روابط و وابستگیهای مهم میان بخشهای مختلف ورودی را محاسبه کند.
به همین دلیل Transformer به یکی از پایههای اصلی بسیاری از مدلهای زبانی مدرن تبدیل شده است.
Attention چیست؟
اگر بخواهیم Attention را خیلی ساده توضیح دهیم، میتوان گفت:
مدل هنگام پردازش یک بخش از متن بررسی میکند کدام بخشهای دیگر ورودی برای فهم یا تولید خروجی اهمیت بیشتری دارند.
برای مثال، در جمله:
«سارا کتاب را روی میز گذاشت چون آن را تمام کرده بود.»
برای درک معنی جمله، ارتباط میان «آن» و «کتاب» اهمیت دارد.
Attention به مدل کمک میکند چنین روابطی را در متن محاسبه کند.
البته سازوکار واقعی Attention بسیار پیچیدهتر از این مثال ساده است.
پارامتر در LLM چیست؟
پارامترها یکی از مهمترین اجزای یک مدل زبانی هستند.
به زبان ساده، پارامترها مقادیر عددی داخلی مدل هستند که در جریان آموزش تنظیم میشوند و نحوه تبدیل ورودی به خروجی را شکل میدهند.
میتوان آنها را مانند تعداد بسیار زیادی تنظیمات عددی در نظر گرفت که مدل در طول آموزش بهینه میکند.
وقتی درباره مدلهایی با میلیاردها پارامتر صحبت میشود، منظور همین مقادیر قابلآموزش است.
اما یک نکته مهم وجود دارد:
تعداد پارامتر بیشتر لزوماً به معنی بهتر بودن مدل در همه کارها نیست.
کیفیت داده، معماری، روش آموزش، بهینهسازی، دادههای پساآموزش، ابزارهای متصل به مدل و روش ارزیابی نیز اهمیت دارند.
LLM چگونه آموزش میبیند؟
آموزش یک LLM معمولاً فرایندی بسیار پرهزینه و چندمرحلهای است.
در مرحله ابتدایی، حجم بزرگی از دادههای متنی جمعآوری و آمادهسازی میشود. این دادهها میتوانند شامل منابع مختلفی مانند صفحات وب، کتابها، مقالات و کد باشند؛ البته مجموعه داده واقعی هر مدل به سازنده و هدف آن بستگی دارد.
دادهها باید تا حد امکان پاکسازی، فیلتر و آماده شوند.
سپس متن به Token تبدیل میشود.
در مرحله Pre-training، مدل بارها با نمونههای مختلف مواجه میشود و در یک وظیفه بنیادی، تلاش میکند Token بعدی را پیشبینی کند.
برای مثال اگر مدل با جملهای مانند:
«امروز هوا بسیار …»
مواجه شود، باید احتمال Tokenهای مختلف را محاسبه کند و ببیند کدام ادامه با الگوهایی که در آموزش یاد گرفته سازگارتر است.
این فرایند بارها و بارها تکرار میشود.
در طول آموزش، پارامترهای مدل با استفاده از الگوریتمهای بهینهسازی تغییر میکنند تا پیشبینیها بهتر شوند.
IBM در توضیح فرایند آموزش LLM در سال ۲۰۲۶، آموزش را بهطور کلی شامل مراحل Pre-training، Fine-tuning و Post-training توضیح میدهد و تأکید میکند که در مرحله پیشآموزش، مدل با پیشبینی Token بعدی الگوهای زبان را یاد میگیرد.
آیا LLM متن را مثل انسان میفهمد؟
اینجا باید کمی دقت کنیم.
وقتی میگوییم LLM «زبان را میفهمد»، منظور لزوماً فهم انسانی نیست.
مدل از طریق آموزش گسترده، روابط آماری و الگوهای پیچیدهای میان Tokenها و مفاهیم یاد میگیرد و میتواند بر اساس آنها خروجی بسیار منسجمی تولید کند.
به همین دلیل، بهتر است درباره LLM نگوییم:
«مثل انسان همه چیز را میفهمد.»
توصیف دقیقتر این است:
LLM میتواند الگوهای پیچیده زبان را مدل کند و بر اساس زمینه، خروجیهایی تولید کند که برای انسان معنادار و منسجم به نظر میرسند.
همین تفاوت یکی از دلایلی است که چرا یک مدل میتواند متن بسیار قانعکنندهای تولید کند و در عین حال درباره یک موضوع خاص اطلاعات نادرست ارائه دهد.
Inference چیست؟
بعد از اینکه مدل آموزش دید، نوبت استفاده از آن میرسد.
این مرحله Inference نام دارد.
وقتی شما یک Prompt وارد میکنید، مدل ورودی را پردازش میکند و بر اساس پارامترهای آموختهشده، احتمال Tokenهای مختلف را محاسبه میکند.
سپس خروجی مرحلهبهمرحله ساخته میشود.
به زبان ساده:
Prompt → Tokenization → پردازش توسط مدل → پیشبینی Token بعدی → تولید پاسخ
این چرخه برای Tokenهای بعدی نیز ادامه پیدا میکند تا پاسخ کامل شود.
بنابراین LLM معمولاً پاسخ کامل را از قبل در یک «فایل آماده» ذخیره نکرده است که همان را برای شما نمایش دهد.
چرا LLM میتواند متنهای مختلف تولید کند؟
چون مدل فقط برای یک پاسخ مشخص آموزش ندیده است.
آموزش گسترده به مدل کمک میکند الگوهای مختلف زبان و انواع ساختارهای متنی را یاد بگیرد.
به همین دلیل یک مدل زبانی میتواند در پاسخ به درخواستهای مختلف:
- مقاله بنویسد
- متن را خلاصه کند
- ترجمه کند
- ایمیل آماده کند
- کد تولید کند
- متن را بازنویسی کند
- سؤال را پاسخ دهد
- سبک نوشتار را تغییر دهد
- اطلاعات موجود در یک متن را استخراج کند
البته توانایی هر مدل به معماری، آموزش، دادهها و امکاناتی که در اختیار آن قرار گرفته بستگی دارد.
Fine-tuning چیست؟
بعد از آموزش عمومی، یک مدل میتواند برای کاربردهای خاصتر تنظیم شود.
این فرایند Fine-tuning نام دارد.
در Fine-tuning، یک مدل از قبل آموزشدیده با دادههای تخصصیتر یا نمونههای مرتبط با یک وظیفه مشخص دوباره آموزش داده میشود.
برای مثال، یک مدل عمومی ممکن است برای کاربردهای سازمانی یا یک حوزه تخصصی خاص با دادهها و دستورالعملهای مناسبتر تنظیم شود.
Fine-tuning به این معنی نیست که مدل از صفر ساخته میشود؛ بلکه مدل موجود برای هدف جدید تطبیق داده میشود.
Post-training چیست؟
آموزش مدل فقط با Pre-training تمام نمیشود.
مدلهای مدرن معمولاً مراحل دیگری را نیز طی میکنند تا خروجی آنها برای استفاده واقعی مناسبتر شود.
این مرحله میتواند شامل روشهایی برای بهبود پیروی از دستورها، کیفیت پاسخ، ایمنی، سبک تعامل و توانایی انجام وظایف مشخص باشد.
به همین دلیل، دو مدل با اندازه مشابه ممکن است به دلیل تفاوت در دادهها و روشهای Post-training عملکرد کاملاً متفاوتی داشته باشند.
RAG چیست و چه ارتباطی با LLM دارد؟
یکی از محدودیتهای LLM این است که مدل بهتنهایی همیشه به اطلاعات تازه یا اختصاصی یک سازمان دسترسی ندارد.
RAG یا Retrieval-Augmented Generation روشی است که به مدل اجازه میدهد قبل از تولید پاسخ، اطلاعات مرتبط را از منابع خارجی بازیابی کند و آن اطلاعات را در اختیار مدل قرار دهد.
برای مثال، یک شرکت میتواند اسناد داخلی خود را در یک سیستم جستوجو قرار دهد و هنگام پرسیدن سؤال، بخشهای مرتبط را به LLM بدهد.
در نتیجه مدل میتواند پاسخ خود را بر اساس اطلاعات بازیابیشده تولید کند، بدون اینکه الزاماً برای هر تغییر داده نیاز به آموزش دوباره مدل داشته باشد.
این روش برای سیستمهای پرسشوپاسخ سازمانی، جستوجوی اسناد و دستیارهای مبتنی بر دانش داخلی بسیار کاربردی است.
LLM چه کاربردهایی دارد؟
کاربردهای مدلهای زبانی بزرگ بسیار گستردهاند.
تولید محتوا
LLM میتواند برای نوشتن پیشنویس مقاله، ایمیل، توضیحات محصول، پست شبکه اجتماعی و انواع دیگر محتوا استفاده شود.
خلاصهسازی
مدل میتواند متنهای طولانی را به خلاصهای کوتاهتر تبدیل کند یا مهمترین نکات یک سند را استخراج کند.
ترجمه
مدلهای زبانی میتوانند بین زبانهای مختلف ترجمه انجام دهند و علاوه بر معنی کلمات، زمینه و لحن را نیز در نظر بگیرند.
برنامهنویسی
LLMها میتوانند در تولید کد، توضیح کد، پیدا کردن خطا و بازنویسی بخشهایی از برنامه به توسعهدهندگان کمک کنند.
چتبات و دستیار هوشمند
بسیاری از دستیارهای گفتوگویی از LLM بهعنوان بخش اصلی پردازش زبان استفاده میکنند.
تحلیل متن
تحلیل احساسات، استخراج اطلاعات، دستهبندی متن و پاسخگویی به پرسشهای مربوط به اسناد از دیگر کاربردهای آنها هستند.
جستوجو و بازیابی اطلاعات
LLMها میتوانند در کنار سیستمهای جستوجو و RAG برای تبدیل سؤال طبیعی کاربر به پاسخ قابلفهم استفاده شوند.
آیا LLM فقط متن را میفهمد؟
مدلهای زبانی اولیه عمدتاً روی متن تمرکز داشتند، اما سیستمهای جدیدتر میتوانند با انواع مختلف داده کار کنند.
به چنین سیستمهایی معمولاً Multimodal AI گفته میشود.
در سیستمهای چندوجهی، مدل ممکن است بتواند با ترکیبی از متن، تصویر، صدا یا ویدیو کار کند.
با این حال، باید میان «LLM» و «سیستم چندوجهی» تفاوت قائل شد. هر سیستم چندوجهی الزاماً فقط یک LLM ساده نیست و ممکن است از چند مدل یا مؤلفه مختلف تشکیل شده باشد.
چرا LLMها گاهی اطلاعات غلط میدهند؟
یکی از مهمترین محدودیتهای LLM، Hallucination یا توهم هوش مصنوعی است.
در این حالت، مدل ممکن است پاسخی تولید کند که از نظر نگارشی کاملاً طبیعی و قانعکننده به نظر برسد، اما بخشی از آن نادرست یا ساختگی باشد.
دلیل این مسئله تا حدی به ماهیت تولید متن توسط مدل برمیگردد: مدل برای تولید خروجی بر اساس الگوهای آموختهشده و زمینه موجود پیشبینی انجام میدهد؛ بنابراین تولید یک جمله روان به معنی تضمین صحت واقعی آن نیست.
به همین دلیل نباید صرفاً به این دلیل که پاسخ LLM حرفهای و مطمئن به نظر میرسد، آن را حقیقت قطعی در نظر گرفت.
برای اطلاعات حساس، بهتر است پاسخ با منابع معتبر بررسی شود.
آیا LLM همان موتور جستوجو است؟
خیر.
موتور جستوجو در اصل برای پیدا کردن و رتبهبندی اطلاعات موجود در منابع مختلف طراحی شده است.
LLM در حالت پایه یک مدل تولید و پردازش زبان است.
البته یک محصول هوش مصنوعی میتواند LLM را به موتور جستوجو متصل کند. در این حالت مدل میتواند اطلاعات جدید را دریافت کرده و آنها را به شکل یک پاسخ طبیعی برای کاربر توضیح دهد.
به همین دلیل، LLM بهتنهایی با Search Engine یکی نیست.
آیا LLM خودش بعد از هر سؤال یاد میگیرد؟
در حالت معمول، نباید تصور کنیم که هر بار با یک مدل صحبت میکنیم، پارامترهای اصلی آن همان لحظه تغییر میکنند.
آموزش مدل و استفاده از مدل دو فرایند متفاوت هستند.
در زمان Inference، مدل از پارامترهای موجود برای تولید پاسخ استفاده میکند.
ممکن است یک محصول از حافظه، دادههای مکالمه، RAG یا سیستمهای دیگر استفاده کند و به همین دلیل در ادامه یک تعامل اطلاعات بیشتری در اختیار داشته باشد؛ اما این با آموزش دوباره پارامترهای اصلی LLM یکسان نیست.
آیا همه LLMها شبیه هم هستند؟
خیر.
مدلهای زبانی میتوانند از نظر موارد مختلف تفاوت زیادی داشته باشند:
- معماری
- تعداد پارامترها
- دادههای آموزشی
- زبانهای پشتیبانیشده
- اندازه Context Window
- توانایی کدنویسی
- توانایی استدلال
- سرعت
- هزینه اجرا
- روش Fine-tuning
- سطح دسترسی
- متنباز یا بسته بودن
- امکان اجرای محلی
به همین دلیل نمیتوان صرفاً با نگاهکردن به عبارت «LLM» نتیجه گرفت دو مدل عملکرد یکسانی دارند.
LLM متنباز چیست؟
در دنیای مدلهای هوش مصنوعی اصطلاحاتی مانند Open Source و Open Weight زیاد استفاده میشوند و نباید آنها را همیشه یکسان فرض کرد.
یک مدل ممکن است وزنهای خود را منتشر کند و امکان اجرای محلی داشته باشد، اما تمام دادههای آموزشی، کدهای آموزش یا اجزای توسعه آن عمومی نباشند.
بنابراین هنگام مقایسه مدلها بهتر است دقیقاً بررسی کنیم سازنده چه چیزی را منتشر کرده است.
آیا LLM به کامپیوتر بسیار قدرتمند نیاز دارد؟
آموزش مدلهای زبانی بسیار بزرگ به زیرساخت محاسباتی عظیمی نیاز دارد و معمولاً به تعداد زیادی GPU، حافظه و سیستمهای توزیعشده نیازمند است.
اما استفاده از یک LLM الزاماً به این معنی نیست که کاربر باید چنین سختافزاری داشته باشد.
بسیاری از کاربران از طریق سرویسهای ابری یا API به مدلهای آموزشدیده دسترسی پیدا میکنند.
در مقابل، برخی مدلهای کوچکتر را میتوان روی کامپیوترهای شخصی یا دستگاههای دیگر نیز اجرا کرد؛ البته سختافزار موردنیاز به اندازه و معماری مدل بستگی دارد.
LLM چه محدودیتهایی دارد؟
با وجود پیشرفت زیاد مدلهای زبانی، LLMها بدون محدودیت نیستند.
مهمترین موارد عبارتاند از:
اطلاعات نادرست:
مدل ممکن است پاسخ نادرست اما بسیار روان تولید کند.
وابستگی به داده آموزشی:
کیفیت دادهها روی کیفیت مدل تأثیر مستقیم دارد.
سوگیری:
مدل ممکن است برخی سوگیریهای موجود در دادههای آموزشی را بازتاب دهد.
هزینه محاسباتی:
آموزش و اجرای مدلهای بزرگ منابع محاسباتی زیادی مصرف میکند.
امنیت:
LLMها میتوانند در برابر حملاتی مانند Prompt Injection آسیبپذیر باشند.
محدودیت زمینه:
هر مدل ظرفیت مشخصی برای پردازش ورودی و زمینه دارد.
عدم شفافیت کامل:
در بسیاری از مدلهای بزرگ، توضیح دقیق اینکه چرا مدل یک خروجی خاص را تولید کرده، ساده نیست.
LLM و هوش مصنوعی مولد چه رابطهای دارند؟
Generative AI یا هوش مصنوعی مولد یک مفهوم گستردهتر از LLM است.
هوش مصنوعی مولد میتواند برای تولید:
- متن
- تصویر
- صدا
- موسیقی
- ویدیو
- کد
استفاده شود.
LLM یکی از فناوریهای مهم در بخش تولید محتوای متنی است.
پس میتوان گفت:
Generative AI یک دسته گسترده است و LLM یکی از مدلهای مهم مورد استفاده در آن محسوب میشود.
LLM و Foundation Model چه تفاوتی دارند؟
Foundation Model نیز مفهوم گستردهتری است.
Foundation Model مدلی است که روی دادههای گسترده آموزش داده شده و میتواند بهعنوان پایهای برای طیف متنوعی از کاربردها مورد استفاده قرار گیرد.
بسیاری از LLMها میتوانند Foundation Model باشند، اما Foundation Model فقط به مدلهای زبانی محدود نمیشود و میتواند در حوزههای دیگری مانند تصویر یا دادههای چندوجهی نیز وجود داشته باشد.
آینده LLMها به کدام سمت میرود؟
مدلهای زبانی فقط بزرگتر نمیشوند؛ مسیر توسعه آنها به سمت کارآمدتر شدن، تخصصیتر شدن و اتصال بیشتر به ابزارها و دادههای خارجی نیز حرکت کرده است.
برخی روندهای مهم عبارتاند از:
- مدلهای کوچکتر و سریعتر
- مدلهای تخصصی برای حوزههای مشخص
- مدلهای چندوجهی
- Context Windowهای بزرگتر
- RAG و اتصال به دادههای اختصاصی
- استفاده از ابزارهای خارجی
- AI Agentها
- اجرای مدل روی دستگاههای شخصی
- بهبود توانایی استدلال و برنامهریزی
- کاهش هزینه اجرای مدلها
در نتیجه، آینده LLM فقط به این سؤال محدود نیست که «مدل چند میلیارد پارامتر دارد؟»
سؤالهای مهمتر این هستند که مدل با چه دادهای آموزش دیده، برای چه کاری ساخته شده، چقدر کارآمد است، چطور ارزیابی شده و چه ابزارهایی میتواند استفاده کند.
یک مثال ساده برای درک LLM
فرض کنید از یک مدل زبانی میخواهید:
«این متن را در سه جمله خلاصه کن.»
در پشت صحنه، اتفاقی شبیه این رخ میدهد:
متن شما → Tokenization → پردازش توسط Transformer → بررسی زمینه → پیشبینی Tokenهای خروجی → تولید خلاصه
مدل ابتدا ورودی را به شکل عددی پردازش میکند و سپس خروجی را مرحلهبهمرحله میسازد.
اگر به همان مدل بگویید:
«همین خلاصه را برای یک کودک ۱۰ ساله بنویس.»
مدل تلاش میکند سبک و ساختار خروجی را تغییر دهد؛ زیرا دستور جدید بخشی از زمینهای است که هنگام تولید پاسخ در اختیار مدل قرار گرفته است.
جمعبندی؛ LLM را ساده بخواهیم بفهمیم
اگر بخواهیم تمام این مقاله را در چند جمله خلاصه کنیم:
LLM یا مدل زبانی بزرگ، یک مدل هوش مصنوعی است که با حجم بسیار زیادی از دادههای زبانی آموزش داده میشود تا الگوهای زبان را یاد بگیرد و بتواند متن را پردازش و تولید کند.
بسیاری از LLMهای مدرن بر پایه معماری Transformer ساخته شدهاند و در فرایند آموزش، پارامترهای خود را برای پیشبینی بهتر Tokenها تنظیم میکنند.
پس از آموزش، مدل میتواند در مرحله Inference به درخواستهای کاربر پاسخ دهد و در کنار فناوریهایی مانند RAG، ابزارها و سیستمهای دیگر، به بخش اصلی بسیاری از محصولات هوش مصنوعی تبدیل شود.
اما یک نکته را نباید فراموش کرد:
LLM هرچقدر هم پیشرفته باشد، پاسخ روان و مطمئن آن الزاماً به معنی پاسخ درست نیست.
شناخت همین محدودیت به ما کمک میکند از مدلهای زبانی بزرگ هوشمندانهتر استفاده کنیم.
سوالات متداول
LLM مخفف چیست؟
LLM مخفف Large Language Model به معنی «مدل زبانی بزرگ» است.
LLM چیست؟
LLM نوعی مدل هوش مصنوعی است که با حجم زیادی از دادههای زبانی آموزش داده میشود و میتواند زبان را پردازش و متن تولید کند.
آیا ChatGPT یک LLM است؟
ChatGPT را بهتر است یک محصول یا سرویس مبتنی بر مدلهای هوش مصنوعی بدانیم. مدل زبانی یکی از اجزای اصلی فناوری پشت چنین سرویسهایی است؛ بنابراین ChatGPT و LLM دقیقاً مترادف نیستند.
Transformer چیست؟
Transformer معماری شبکه عصبی است که با استفاده از مکانیزم Attention میتواند ارتباط میان بخشهای مختلف ورودی را پردازش کند و یکی از پایههای اصلی بسیاری از LLMهای مدرن است.
LLM چگونه آموزش میبیند؟
فرایند آموزش معمولاً با جمعآوری و آمادهسازی دادهها آغاز میشود، سپس متن به Token تبدیل شده و مدل در مرحله Pre-training با پیشبینی Tokenهای بعدی آموزش میبیند. بعد از آن ممکن است مراحل Fine-tuning و Post-training انجام شود.
آیا LLM واقعاً زبان انسان را میفهمد؟
LLM میتواند الگوها و روابط بسیار پیچیده زبان را مدل کند و خروجیهایی بسیار طبیعی تولید کند، اما این موضوع با «فهم انسانی» یکسان نیست.
آیا LLM میتواند اشتباه کند؟
بله. LLM ممکن است اطلاعات نادرست یا ساختگی تولید کند؛ به همین دلیل پاسخهای آن، مخصوصاً در موضوعات حساس، باید بررسی شوند.
RAG چیست؟
RAG یا Retrieval-Augmented Generation روشی است که به مدل اجازه میدهد اطلاعات مرتبط را از منابع خارجی بازیابی کرده و هنگام تولید پاسخ از آنها استفاده کند.
آیا همه LLMها بزرگ هستند؟
LLMها در مقیاسهای مختلف ساخته میشوند و مدلهای کوچکتر و تخصصی نیز وجود دارند. «بزرگ» در اصطلاح LLM بیشتر به مقیاس مدل و داده و محاسبات مربوط است و الزاماً به معنی یک اندازه ثابت نیست.
LLM چه کاربردهایی دارد؟
تولید محتوا، خلاصهسازی، ترجمه، پاسخگویی، تحلیل متن، برنامهنویسی، چتباتها، جستوجو و بسیاری از ابزارهای هوش مصنوعی از مهمترین کاربردهای LLM هستند.
این مطلب بر اساس گزارش وبسایت ibm ، cloudflare ، stanford ، dataversity بازنویسی شده است.